00:01예, 모두여는 10년차 AI 연구 커뮤니티고요
00:01얼마 전에 10주년 행사를 진행했습니다
00:08저희 DR4R은 현재 그 7기 예, 시즌 7을 진행 중에 있고요
00:16오늘은 그 박철에 랩장님이 VLA 모델이 진화와 로봇 지능 미래를 발표할 예정했습니다
00:24어, 양이 좀 많으세요
00:24한 70페이지 정도 되고 한 페이지당 1분간 빠르게 진행하실 예정이고요
00:29어 1한시간 끝나고 나서 Q&A를 받는 걸로 할 진행 예정에 있습니다
00:36그럼 박수로 부탁드리겠습니다
00:36[박수] 네
00:43예
00:43안녕하세요
00:43예, 박철입니다
00:43저 오늘 그 VLA 비전 랭귀지 액션 모델의 진화 로봇 지능 미래 이걸 주제로 발표를 하도록 하겠습니다
00:57그래서 모드연 소개는 아까 이제 소개하셔서 예, 넘어가도록 하겠습니다
01:03그다음에 오늘은 DR 소개 간단하게 하고 오프닝 그다음에 V LNM 예, 철저 틀렸네
01:11VLM VLA 개념적 진화하고 그다음에 VLA용 데이터셋 그다음 대표 VL 모델 한 열 개 정도를 쭉 시간 순서대로 한번 진행을 좀 해 보도록 하겠습니다
01:25그다음에 VLA의 숙제 응용
01:31저희는 이제 2017년도 9월부터 해서 한번 진행했었고 코로나 때 잠깐 쉬다가 이제 DR로 해서 2022년 8월에 다시 시작해서 지금 시즌 7까지 왔습니다
01:37그다음에 이제 이런 로봇 관련해서는 저희가 5 시즌 5부터 진행을 했었습니다
01:54그래서 지금 시즌 1은 2022년 8월부터 해서 시즌 5가 2024년 5월부터 해서 567 해 갖고 저희 로봇 관련된 내용들을 쭉 다루게 됐고요
02:02시즌 5에서는 저희가 이제 UMI라고 해서 디퓨전 폴리시 관련되 있는 것들을 쭉 진행을 했었습니다
02:08그래서 그중에 이제 그 아직 그 VLA가 오픈되기 전이었기 때문에 그래서 지금 그때 저희가 이제 이걸 가지고 진행했고 시즌 6은 르로봇이라는 것이 나와서 대중화가 되겠다 싶어서 그때 이제는 그 VLA도 지금 같이 있 있고요
02:35그다음에 르로봇이 저가 모델이고 한 60만 원 정도면 구매 가능하고요
02:40그다음에 다양한 모델을 하나로 이렇게 다 통합을 했습니다
02:40그래서 이제 그런 모델들 통합이 됐기 때문에 비교해 볼 수가 있고요
02:47일단 자체 로봇 플랫폼을 이제 구축할 수 있어서 그때 이제 저희가 ACT나 디퓨전 폴리시 파터디를 좀 했고요
02:54실질적으로는 ACT만 돌려봤어요
02:59왜 그러냐면 그 저희 GPU나 이런게 확보가 안 돼서 그래서 이제 ACT만 돌려봤던 상태고요
03:05그다음 유니티로 좀 시뮬레이션을 구현을 해 본 경험이 있습니다
03:11그래서 지금 요거는 이제 유니티로 해서 이제 실질적으로 유니티 환경에서 가상 환경에서 촬영하고 데이터셋 모으고 학습시키고 그다음에 실제 이제 동작시켜 보는 요런 가정까지 진행을 했습니다
03:24시즌 7에서는 이제 다양한 VLA 모델을 지금 동작 테스트는 못 해 봤어요
03:30사실 이제 이건 또 이제 GPU가 확보가 안 되다 보니까 그렇지만 이제 스터디를 한 내용을 가지고 오늘 쭉 진행을 해해 볼 생각이고요
03:36네
03:43그다음에 이제 로봇의 로봇제 흐름 방식의 진화의 흐름을 보면은 전통적인 롤베이스로 하던 것들이 이제 일반적인 내용들이었죠
03:48그러다가 이제 로라든가 오브젝 디텍션을 통해서 룰베이스로 이제 어떤 사물을 이제 보고하는 이런 형태로 되었던 것이 이제 2020 2년 쯤까지가 이제 그때까지의 어떤 내용이에입
04:06그러니까 어 전통적인 로봇 제어은 아예 눈 감고 정확하게 아무것도 못 보고 그다음에 이제 어 비전 기반 제어은 눈을 떴지만 그래도 룰베이스로 이제 진행하는 이제 모방 학습 기반은 이제 엔드투트 엔드로 들어가는 거죠
04:22그래서 엔드투 핸드로 해서 이제 처음부터 끝까지 어 제어 이제 실질적으로 하하되 어떤 지금 보시면 여기 보 트레토리하고 트레토리 단계 어떤 위에서부터 내가 있어서 지능이 있어서 뭔가 이렇게 지시를 받고 하는게 아니고 그냥 어떤 잡 특정한 어떤 일을 이제 엔드로 이제 하는 형태가 어 모방 학습 기반 학사 모델 ACT나 디퓨전 폴리시 이런 부분들이 해당되는 되는 내용들이고요
04:49VLA 기반 엔드투엔드 제어는 아직 아예 이제 LNM이 내의 역할을 하고 거기에 제 근육과 같은 모터가 이제 근육과 같이 이제 연결이 돼서 마치 이제 내에서 어떤 명령을 받으면 그것을 실제 이제 로봇이 실행할 수 있도록 해 주는 그런 지능을 갖게 되는 형태로 이제 되어졌다라고 볼 수가 있습니다
05:18그래서 생성력 AI 등장 및 이제드 AI가 이제 실제 생성력 AI 등장 LNM이 실질적으로 이제 계속 진화해서 LNM VLM 그다음에 VLA 이런 식으로 쭉 이제 진화를 하게 된 상태고요
05:30그래서 실질적으로 그게 물리적인 어떤 현상들을 이제 모토를 통해서 동작을 시켜 주는 이런 부분들을 이제 엠바디드 AI 이렇게 이제 그런 식으로 이제 우리가 볼 수가 있습니다
05:49여기서 이제 이중 처리 이론이라고 해서 어 여기서 이제 근래 이제 시스템들이 두 가지로 나눠서 처리합니다
05:55시스템과 시스템 2로 해서 이제 해서 이제 시스템이 로레벨이고요
06:02시스템 2가 이제 하이 레벨이에요
06:02그래서 로레벨 하이 레벨로 나눠서 이제 보통 처리를 하도록 하는 것들이 여기서 이제 대니얼 카네카 캐너먼이라는 분이 이중처리 이론을 근거를 해서 이제 요즘에 이제 나오는 것들은 이렇게 시스템과 시스템 2로 동작이 되도록 처리하는 요런 식으로 이제 되어진다라고 볼 수 있어요
06:26대부분이 이제 시스템 원에서 많은 동작이 이루어지고요
06:26한 95%가 이제 왜 그러냐면 계속 이제 반응을 보이고 액션을 하고 하는 부분들이 이제 롤앱에서 이루어지고 플랜을 싸고 뭐 타스크를 만들고 하는 부분들이 상위 레벨에서 이루어지는 이런 부분들이라고 볼 수가 있습니다
06:47그래서 이제 이중 레벨 전문가 시스템을 해서 LNM과 디퓨전 디코더를 결합을 하는 거죠
06:47결국 VLA는 이런 VLM VLM과 어 디퓨전 디코더를 결합을 해서 VLA가 된 거고요
06:59그루트 엔원이나 피규어 AI 여기서 제 그 휴먼노이드 로봇까지 이제 실질적으로 이제 커버하는 2025년부터는 휴먼노이드를 대상으로 하는 이런 이제 VLA 버전들이 쭉 이제 나오기 시작한 거고요
07:12어 그다음에 이제 범형 기반 실질적으로 이제 파이 0.5가 가 이제 피지컬 인텔리전스에서 이제 범형성을 좀 기반을 하는 그런 로봇들이 이제 이것도 마찬가지로 이중 레벨 전문가 시스템을 도입을 하고 있습니다
07:30그래서 시스템 2는 느린 사고 그다음 시스템은 빠른 사고 이렇게 해서 롤레벨에서 굉장히 그냥 마치 이제 조건 반사하듯이 그렇게 해서 이제 쭉 동작을 하도록 만들어 주는 것
07:37그다음 위에서 이제 플랜을 만들고 그다음에 타스크를 만들고 해서 이제 좀 더 이렇게 세부적으로 일을 나눠서 처리할 수 있도록 해 주는 그런 부분들이 이제 시스템 2라고 볼 수가 있습니다
07:51그래서 뭐 일단은 뭐 이렇게 저도 뭐 이렇게 이거를 남의 걸 보고 한 건 아니고 저 나름대로 이제 타스크 뭐 시스템 이렇게 어떤 어떤 곳에서는 타스크가 위에 있고 플랜이 아래 있고 이제 그렇게 돼 있어요
08:05그러니까 실제로 이제 위쪽에 있는 것이 좀 약간 롱텀 굉장히 전 처음부터 끝까지 어떤 업무라고 본다면 아래에 해당되는 것은 좀 더 이렇게 세부적으로 나눈 그 일들을 세부적으로 나눴다라고 볼 수가 있고요
08:19이제 이런 거죠
08:19머리는 똑똑한데 손이 더디 더디어도 안 되고 그죠? 그 근데 손은 빠른데 머리가 안 좋아도 안 되고 실질적으로 일을 잘하는 사람들은 머리도 좋고 내 손도 이렇게 빠 잘하는 이제 그런이 삼박자가 이렇게 여기서 보면은 잘 이루어질 수 있도록 시스템이 구현이 돼야 되는 것이고 VLA도 마찬가지로 이런 시스템의 흐름대로 이제 처리가 되어 처리가 되어져야 된다라고 이제 볼 수가 있습니다
08:50그래서 여기서 보면 고수증 계획과 좀 이제 처음부터 끝까지 어떤 계획이고요
08:50그 그 처음부터 끝까지 계획들을 세부적으로 나누고 그 세부적으로 나눈 것들을 실제 어떻게 동작시킬 것인가 하는 부분들이 이제 가장 밑에 액션 트레토리 이런 부분에 해당됩니다
09:03그래서 이제 처음에는 이제 액션 단위 한 하나하나씩 이렇게 하던 것들을 지금은 이제 트레토리 단위로 그니까 어떤 액션의 묶음 이런 형태로 이제 정영화되어 가는 그런 수준이다라고 볼 수가 있습니다
09:23그래서 결국 이제 범명성이 굉장히 중요한 것으로 이제 법명성이라는 것은 뭐냐면 꼭 일을 시킨 것이 아니고 비슷한 업무들이 주어졌을 때 그 업무를 수행할 수 있는 능력을 이제 범명성이라고 얘기를 합니다
09:37제너럴리스트라고 하는데 그 제너럴리스트는 이제 가령 이제 주방이면은 어떤 주방의 어떤 것들은 거의 비슷한 배치가 있고 비슷하지 않습니까? 그런데 다 집마다 다르잖아요
09:44그 한 열 군데 정도만 학습이 되면 아무 아무 군데가 가서도 그 주방에 일을 할 수 있도록 해 주는 이런 범명성 그런 그럼 이런 범행성은 어디에서 나오는가 하는 부분들을 이제 하나씩 이제 체크할 거고요
09:58그래서 고려 사항이 이제 여기서는 딱요네 가지가 트레이드오프 관계를 갖고 있어요
10:04범용성 그다음에 경량화 실제적으로 이제 이것 인벤지 시스템에 들어가야 되기 때문에 결국 이제 lnm은 굉장히 거대 모델로 계속 이제 그 파라미터 커지지만 여기서는 될 수 있으면 반대로 파라미터를 작게 하면서도 이제 좀 더 성능이 좋아지도록 이렇게 하는게 이제 경량화에 해당됩니다
10:28그다 정확성 그러니까 어떤 동작의 정확성 이제 가장 롤레벨에 해당되는 것이죠
10:34여기서 이제 디퓨전을 도입해서 그렇게 해서 이제 여기서 이제 플로 매칭을 이제 거의 이제 정용화 돼 있는데 플로 매칭을 통해서 조금 더 정확한 동작들을 이제 구현할 수 있도록 실시간이 또 필요하죠
10:48그 그러니까 이것이네 개가 물리고 물려 있어요
10:55결국은 이제요 어떤 걸 하게 되면 어떤게 조금 이제 안 되고 이제 적절하게 그러면서 이제 그런 것들이 전반적으로 그런 시스템이 이제 성능이 더 좋아질 수 있는 방향으로 이제 계속 진행한다
11:07요걸 이제 요런 관점에서 제가 계속 앞으로 설명할할 것들은 요런 어떤 관점에서 제가 설명을 드릴 생각입니다
11:15범형성이 어떻게 되는가? 각 시스템이 그다음 경량화는 어느 정도인가? 그다음에 정확성은 어떤가? 그다음 실시간은 이제 어떤가 하는네 가지 정도의 관점에서 이제 VLA를 바라봐야 된다라고 볼 수가 있습니다
11:29그다음에 이제 실제로 이제 LNM, V, VLM, VLA 개념적 진화가 되어져 있죠
11:35지금 사실은 이제 채치T나 재미나이나 이것은 다 VLA 개념을 VLM 개념을 갖고 있어
11:48그니까 지금 이제 지금 뭐냐면 단순히 텍스트 텍스트가 아니고 이제 비전이라든가 이미지라든가 이런 걸 다 아암마리 처리를 하고 있어요
11:55이제 그래서 실질적으로 이제 우리가 VLM에서 VLA로 넘어가는 것들 그러면 여기서 제 결국은 제가 보기에는 이제 로보트 L&M을 잘하는 사람이 사실은 로봇의 승자가 될 수 있어요
12:10그래서 여러분들이 아마 이제 이쪽 계열로 들어오게 된다면 결국은 LN을 얼마나 잘 알고 있느냐
12:16이것이 실질적인 어떤 로봇의 이제 승부가 되지 않을까 그렇게 생각합니다
12:22결국 그렇게 돼 버렸어요
12:27그래서 LNM을 잘하는 저도 그래서 사실은 저는 이제 비전 쪽 AI 쪽을 많이 했었었는데 실제적으로 이제 LNM 쪽을 굉장히 열심히 요즘 보고 있습니다
12:34그래서 LNM에 관련된 것들을 얼마나 많이 아느냐가 실질적으로는 VLA나 이런 쪽을 잘할 수밖에 없다로 이렇게 기결이 된다라고 볼 수가 있습니다
12:47그래서 타임라인을 쭉 보게 되면 2019년에 트랜스포머 기반의 TO가 나 이게 빨간색이 이제 처 쳐져 있는 건 실제 이제 VLA 적용이 돼 있던 요거 이거는 거대 모델은 아니지만 이제 RX1이라는 곳에 이제 변형된 모델로 사용이 된 것이고요
13:04쭉 이제 타임라인을 봐서 이제 팜이라고 해서 얘가 이제 RT2 그다음에 이제 이것도 RT2에 해당되고 라마가 실질적으로 어디에 쓰여 있냐면은 그 오픈 V에 쓰여 있어요
13:22그다음에 여기 이제 잼마라는 것이 이제 파이 이런 쪽에 사용이 되어져 있습니다
13:27그래서 실질적으로 LNM을 베이스로 해서 이제 VLM 그다음에 VLA 이런 식으로 즉 빌드업이 돼 있는 상태라고 볼 수가 있습니다
13:32이제 불과 사실은 LNM이 나온 것은 2022년도 그 정도라고 볼 수 있어요
13:403년 안에 굉장히 엄청난 변화가 있는 거죠
13:45그건 사실은 이제하고 똑같죠
13:522022년도에 나와서 3년 만에 엄청난 변화가 있듯이 똑같은 어떤 흐름으로 가고 있다라고 볼 수가 있습니다
13:58그래서 지금 보시면 LNM은 텍스트 텍스트예요
14:05이걸 이제 내라고 볼 수 있지
14:05이제 두뇌라고 볼 수가 있고요
14:05얘는 이제 듣고 말하고 뭐 이런 어떤 형태로 볼 수가 있어요
14:10텍스트 이제 우리가 그다음에 이제 VLM은 이제 보고 듣고 그다음에 그걸 말하고 뭐 이런 식으로 이제 되는 것이고요
14:16얘는 이제 여기에 이제 촉수가 달려서 내 촉수가 달려서 이제 근육을 움직이듯이 마찬가지로 얘는 이제 보고 듣고 이제 내 자세를 파악한 다음에 어떤 여기서 텍스트 대신에 액션으로 요렇게 이제 처리가 되는 요것이 이제 어 VLA다 이렇게 볼 수가 있습니다
14:35그래서 이제 실질적으로 이제 결국은 기본적인 속성은 어디 있느냐? 이제 LNM이라는 곳에 있는 거예요
14:47그래서 기본적인 속성은 이제 LNM을 여러가 결국은 이제 VLA도 그런 깊은 내막을 알 수가 있다라고 볼 수가 있는 거죠
14:57그래서 이제 이렇게 해서 이제 LNM이 있습니다
14:57트랜스포머 기반이죠
14:57트랜스포머 이제 디코드를 통해서 이제 쭉 해서 얘가 LNM은 사전 학습을 하고 SFT 이제 튜닝을 하죠
15:10파인 튜닝하고 그다음에 RLHF나 이런 식으로 해서 얼라인먼트까지를 이제 쭉 진행을 한 것이요 이제 LNM에 해당된다라고 볼 수가 있는 것입니다
15:23자, 여기다 이제 우리가 비주얼 비주얼 백본이라고 해서 이제 이미지가 들어오면은 비디 비전 인코더가 붙어 있고 그다음에 이제 뭐 클립이라든가 이런 인터페이스가 연결이 되고 그렇게 해서 이제 이것이 토큰으로 이제 벡터 형태로 의미 공간으로 들어오게 되는 것이죠
15:40그렇게 해서 얘는 이제 사실 그 거기로 들어오게 되면 얘는 이제 언어인지 비전인지 모르죠
15:47그냥 어 의미 공간이 어떤 것으로 해서 그냥 그대로 처리하면 되는 것이죠
15:53자, 이런 식으로 해서 이게 VLM에 해당되는 것이고요
15:59그다음에 이제 VLA라고 해서 이제 그 LNM대 이제 텍스트 대신에 액션을 그냥 쭉 붙여 놓은 것
16:06초기에는 이제 요렇게 돼 있어요
16:06그냥 바로 그냥 척수 없이 바로 그냥 이제 하나씩 하나씩 이제 약간 지나간 관계에서는 약간 이제 덜 진화가 돼 있는 이제 그런 상태라고 볼 수가 있고요
16:19근데 여기서 이제 보시면은 텍스트를 우리가 이제 보면은 VLM에서도 텍스트 대신에 영상을 내가 출력하고자 한다면 디퓨전 계열을 쓰죠
16:24디퓨전 계열를 써서 이제 뭐 이제 디퓨전 폴리시라든가 아니 DDPM이라든가 아니면은 이제 플로우 매칭을 써서 영상으로 변화를 시켜 주듯이 마찬가지로 영상 대신에 액션으로 바꿨다 이렇게 이제 보시면 되겠습니다
16:45그래서 얘도 지금 보면 노이즈를 통해서 결국 이제 여기서 디퓨전 트랜스포머가 하나 더 붙어요
16:53요게 이제 마치 척수와 같은 역할을 한나 이거죠
16:53이렇게 해서 이제 마치 이제 여기서 이제 액션들을 만들어 내는데이 액션들은 이제 트라토리 즉 이제 하나의 액션 단위가 아니고 어떤 일정 길이의 액션을 이제 만들어 주게 되는 것이고요
17:07그때 이제 여기서는 이제 디퓨전 개념 확산 모델을 쓰고 있기 때문에이 확산 모델에서 실질적으로 이제 그 노이즈를 주게 되면 얘는 이제 해당되는 것들을 어 속도 이제 쭉 이제 나중에 트레토리로 노이즈를 다 제거하고 나서 실제 이제 트레토리로 그니까 이미지 대신에 트레토리라고 볼 수가 있고요
17:36이미지는 2차원인데 얘는 1차원이죠
17:36그까 조금 더 이렇게 경량 될 수 있는 그런 소지가 있다라고 볼 수가 있습니다
17:42그래서 이제 LNM은 우리가 이제 기본적으로 이렇게 프리트레이닝을 하고 파인 튜닝을 하는데 그 파인 튜닝 안에는 SFT라고 해서 이제 그 이제 지시 명령어를 이제 대답과 응답할 수 있게끔 그다음에 RLHF로 해서 얘가 이제 어떤 얼라인먼트 선호도를 이제 해 갖고 처리한 다음에 이제 프롬프티 엔지니어링을 하죠
18:10그렇게 해서 이제 얘가 똑같이 VL에도 이제 요런 과정을 거친다
18:17세 번 세벌구이다라고 볼 수 있어요
18:17그니까 LNM으로 해서 이렇게 해서 어 프리트레이닝, 파인튜닝 그다음에 VLM 관련해서도 다시 그거 할 때도 프리트레이닝하고 파인튜닝 해야 되고 다시 또 VLA 할 때도 다시 VLA 관점에서 어 프리트레이닝하고 화인 튜닝하고 이걸 세 번 반복을 한다라고 볼 수 있어요
18:42근본적으로 봤을 때는
18:42그래서 이제 사전 학습을 이제 진행하는데 사전 학습은 이제 거대 텍스트죠
18:49굉장히 많은 방대한 데이터를 이제 그 자기지도 학습을 통해서 처리하게 되면은 말을 잘하는 어떤 이제 머신이 나온 거죠
18:56근데 얘는 대화가 안 되죠
18:56말만 잘하고 대화가 안 되는 그래서 그 대화를 잘하 잘하기 하기 위해서 이제 하는 것이 SFT라고 이제 보보는 것이죠
19:10SFT라는 것은 이제 질문과 응답을 이제 세트로 해서 쭉 이제 계속 학습을 시키면은 얘는 이제 말 잘하는 놈이 질문과 답을 되게 잘하게 되는 근데 이제 할 말 못 할 말을 또 가려야 돼요
19:21무조건 뭐 질문했을 때 다 대답하면 안 되니까
19:21그럼 그거를 이제 조율하는게 이제 RLHF입니다
19:27그래서 선호도를 조사해서 얘가 이제 할 말 안 할 말을 이제 가려낸다라는 것이 이제 실질적으로 이제 어떤 그 LNM의 전반적인 학습 과정에 해당되는 것이고요
19:40이제 VLA도 사실은 이런 과정을 거의 비슷하게 겪고 있어요
19:40지금은 이제 파인 튜닝하 프리트레이닝하고 파인 튜닝 단계에만 있지만 실질적으로 이제 여기서도 이제 어 선호도 조사라는 것은 뭐예요? 어떤 같은 이제 질문했을 때 여러 개 답이 나오면이이 답이 더 좋아하고 이제 지정해 주면 그 해당되는 것에 따라서 처리하듯이 액션도 마찬가지죠
20:02이제 어떤 이제 지시를 따라서 어떤 액션을 취했을 때 그 지시 사항에 대해서 이제 여러 개 액션들이 나올 수가 있는데이 액션이 더 좋아하는 식으로 이제 처리하면서 그러면 이제 조금 더 정교하게 튜닝이 될 수 있어요
20:21근데 아직까지는 여기까지 이렇게 간 건 아니지만 앞으로는 이제 이런 강화학습 강화학습 기반으로 하고 있죠
20:27이런 부분들을
20:27그래서 강학습이나 이런 것들이 이제 마지막 단에 도입이 되는 그런 형태가 되지 않을까 그렇게 생각합니다
20:34자, 그다음에 여기서 보시면 어 체인 오브 소시라고 해서 이제 어쨌든 이거는 이제 처음에는 프롬프트 엔지니어링 할 때 이제 스텝바이 스텝을 해줘라고 하면은 그 하던 것들을 이제요 조금 더 이렇게 명시적으로 이제 하기 위해서 SFT 레벨로 체인 오브 토시이 넘어가듯이 마찬가지로 얘도 지금 보시면 어 체인 오브 토시 이제 VLA도 굉장히 많이 적용이 되고 있는 상태예요
21:01이렇게 해서 아예 질문할 때 조금 더 이렇게 SFT 레벨에서 파인 튜닝 레벨이죠
21:08파인트 레벨에서 그런 부분들을 잘 이렇게 대답할 수 있도록 하면은 뭐 체계적으로 이제 전체를 어떤 큰 이제 타스크를 조금 굉장히 디테일하게 이렇게 뽑 뽑아 준다든가 왜 그러냐면 우리가 수학 문제 풀 때 뭐 이거를 이제 체인 오브 소스로 적용하게 되면은 좀 더 이렇게 어떤 스텝바이 스텝으로 이렇게 풀어 풀이 과정을 알려 주듯이 마찬가지로 동작 동작을 좀 더 세분화해서 해당되는 동작들을 이렇게 알려 줄 수 있게끔 해 주는 부분들이 이제 체인 오브 소입니다
21:40근데 문제는 뭐냐? 이런 걸 하려면은 속도가 느려져요
21:46그러니까 이제 그런 걸 적절하게 아까 이제네 가지 측면을 고려한단 말이에요
21:46지금 현재 우리가 이제 VLA를 쓰고 쓰고자 할 때는네 가지 측면들을 고려를 해 줘야 된다는 것이죠
21:52그래서 아까 범형성 문제, 정확성 문제, 그다음에 이제 경량화 문제, 그다음에 하나가 이제 잊어버렸죠
21:59뭐 어쨌든네 가지 요런 부분들을 어떤 걸 하면 어떤 건 좋아지고 나빠지고 이제 이런 것들이 사실은 감이 잡혀지지만이 되는 이런 부분들입니다
22:12그래서 이제 우리가 이제 lnm에서지도 학습 미세 조정에서 SFT라는 것은 뭡니까? 이제 어 사전 학습은 대량의 데이터가 중요하지만 그지도 SFT는 고품질 데이터가 더 중요해요
22:33즉 질문 응답에 질이 좋아야 된다는 얘기야
22:33아 많은 양의 데이터 질문 응답을 만드는게 아니고 그 질문 응답을 조금 더 이렇게 고품질로 만들어 주는 것이 굉장히 중요하다
22:45그래서 여기서는 30개에서 50개의 고품질 예시 만들어도 스타일 전환이 가능하다
22:45그래서 여기서도 V도 마찬가지예요
22:52그러니까 여러분들 찾아온 학습은 굉장히 방대한 데이터들을 요구하고 있어요
22:52그렇지만 파인튜닝 할 때는 그 방대한 데이터를 요구하는게 아니고 어떤 우리가 이제 그 모방 학습에서 리더하고 팔로잉 할 때 그 데이터를 아주 그냥 많은 데이터가 아니고 되게 정확한 데이터 정확한 동작들 이런 것들이 더 실질적 중요해요
23:16어떤 단계로 이렇게 학습이 되느냐에 따라서 사실은 이제 이것이 많아야 되느냐 정확성을 요구하느냐 이런 부분들이 이제 달라질 수가 있다라고 볼 수가 있습니다
23:23그다음에 이제 RLHF 이렇게 해서 실질적으로 이제 어떤 세 단계 과정에서 보상 모델 학습이라고 해서 이제 우리가 요거를 이제 먼저 모델이 나오면 쭉 이제 질문을 던져 주면 각기 다른 대답을 하게 되면 이제 그걸 가지고 이제 사람이 그거를 이것 이것이 더 좋아 나빠 이런 식으로 이제 선호도를 만들어 주고 다시 그걸 강화학습으로 이제 pp오나 이런 거로 다시 이제 네트워을 훈련을 시켜서 그런 선호도를 을 이제 유지하게끔 이렇게 하듯이 마찬가지로 어 VLA도 실질적으로 어떤 액션이 더 좋아 뭐 이런 식으로 이제 하면서 조금 더 이렇게 튜닝을 더 해 나가는 거죠
24:08세부트닝을 이제 해 나가도록 이렇게 해서 어 피지컬 인텔리전트를 이제 만든 사람이 요즘은 이제 강화 학습을 이제 도입을 해야 될 때 정도로 이렇게 계속 강조를 하고 있는 이제 그런 단계다라고 볼 수 있습니다
24:23그다음에 이제 그 이거는 이제 딥시크에서 만든 거죠
24:23그래서 PPO나 이런 거 대신에 어 GRPO나 이런 것들을 해서 단계를 넘겼듯이 마찬가지로 여기서도 이제 VL에서도 이런 GRPO나 이런 것들을 도입을 하고자 하는 그런 어떤 흐름도 요즘은 이제 보여지고 있습니다
24:42그래서 요즘 곧 근래 논문들은 뭐 GR표라든가 COT 그니까 체인 오브 소시라든가 이런 부분으로 이제 넘어가는 조금 더 이렇게 그거는 뭐냐면 세부 튜닝을 좀 더 잘해 보자라는 컨셉으로 이제 많이 이제 들어와 있다라고 볼 수가 있습니다
25:01그래서 이제 우리가 VLM으로 넘어가서는 이제 멀티모델 LNM인 것이죠
25:07실질적으로 이제 우리가 전체적으로 VLA의 관점뿐만 아니라 전체적으로 봤을 때는 텍스트뿐만 아니라 이제 이미지, 비디오, 오디오, 3D 등 다양한 형식의 데이터를 이해하고 생성할 수 있는 LNM을 우리가 멀티모델 LNM이라고 우리가 실제로 조목하는 것은 이미지죠
25:19현재는
25:19그리고 나중에 이제 비디오 그 어 이제 이런 식으로 이제 넘어가게 되는데 그래서 텍스트와 이미지는 처리가 활 거의 지금 많이 단계가 와 있는 상태죠
25:38그다음에 이제 비디오 오디오는 이제 초기 단계이고요
25:43그다음에 이제 저희가 그러면 여기서는 보시면 얘가 이제 LNM이고요
25:43기존의 텍스트입니다
25:50그럼 멀티모델을이 하기 위해서는 여기서 보시면 인코더가 필요하고요
25:55그다음에 이제 프로젝터 인풋 프로젝트가 필요하고 요런 것들이 추가가 돼야 됩니다
26:02그다음 출력을 우리가 액션으로 만들기 위해서는 마찬가지로 이제 아웃풋 프로젝트하고 그다음에 모달리티 이제 제너레이션 그럼 여기서는 이제 우리가 VLA에서는 마찬가지로 이미지하고 텍스트 그다음에 자세를 여기서 이제 받아서 처리할 수 있도록 해 주는 이제 모달리티 인코더 그럼 이제 여기서는 이제 비전 인코더를 이제 도입을 해야 되는 것이고요
26:24그다음에 인풋 프로젝터를 통해서 이제 우리가 처리하고자 할 때는 요거는 이제 정합을 하는 거죠
26:31실질적으로 이제 여기서 이제 우리가 토큰을 이제 벡터 형태로 의미 공간으로 집어넣을 때 약간 지금 여기서 나온 의미하고 얘가 실질적으로 원하는 의미가 달라질수 다른 약간 정합이 안 돼 있으니까 중간에 MLP를 중간에 멀티레어 퍼집트론을 집어넣어서 얘가 이제 중간에 이런 학습을 계속 시켜요
26:55여기서 보시면 여기서 얼음처럼 돼 있는 거는 프로즈된 거예요
27:01그러니까 파라미터 변화가 안 되고 여기요 얘네들을 계속 튜닝을 해서 정압성을 높인다라는 것입니다
27:08음
27:08그다음에 마찬가지죠
27:08여기서 이제 우리가 액션이라는 것을 뽑아내기 위해서는 여기서도 이제 아웃풋 프로젝트하고 그다음에 여기서 이제 우리가 여기 이걸 우리가 뭐를 쓰냐면 디퓨전 계열에 이제 학습 모델을 쓰고 쓰는 것으로 일반적으로 이제 정형화 돼 있는 이제 그런 상태입니다
27:21그래서 임 입력은 이미지하고 자세 텍스트 이런 쪽으로 이렇게 받아 받아서 입력을 받 들어가고 출력은 이제 액션 액션 트레토리 이런 식으로 이제 처리되는 것이 일반화된 이제 멀티모델 LN에 이런 식으로 적용을 할 수가 있다라고 볼 수가 있는 것입니다
27:42그다음에 이제 비전 쪽을 처리할 때 이미 이제 우리가 VLM에서는 클립 혹은 C그립 이런 것들을 통해서 이미지하고 그다음에 이제 텍스트를 정합을 하죠
27:55그럼 이쪽이 이제 텍스트의 토큰들이죠
28:01텍스트 그리고 이쪽이 이미지인데 얘하고 얘를 같은 공간에 집어 넣는 거예요
28:01그래서 이제 대조적으로 여기 이제 보시면 같은 위치에 있는 것들은 얘가 이제 어 이제 뭐죠? 이제 저기 어 로스를 작게 하고 그다음에요 하얀색 부분 로스를 크게 하는 대조적인 어떤 컨트 컨트라스티브 랭귀지 이미지 이제 프리 어 리 프리 트레이닝이라고 해서 이제 그 오픈 AI에서 2001년도에 공개 모델을 공개한 모델인데 오픈 소스는 아니에요
28:36지금까지도 사실은 이렇게 오픈하지 않았는데 오픈 클립이라고 해서 걔네들이 만들지 않았지만 오 다른 데서 그거를 똑같은 방식으로 만들어서 오픈을 한 거죠
28:50그렇게 해서 이제 처리한 거고요
28:50얘네들은 로스가 뭐냐면 이제 소프트맥스를 통해서 얘네들의 어떤 로스를 구합니다
28:58이거는 이제 우리가 얘네들 얘 얘를 가지고 계속 사 학습을 시키는 거야
29:03그리고 나서이 학습된 거를 붙이는 거죠
29:09lnm에다 붙여요
29:09그래서 얘는 지금 보 그래서요 지금요 토큰요 지금 토큰들 벡터들이이 이미지 이미 이미지이 이미지 벡터와 얘 이미지가 되도록 왜 그러냐면 얘가 지금 학습을 시키면 얘하고 얘가 같아야지만이 로스가 적어지는 거거든요
29:23그래서 얘 얘하고 얘가 의미 공간상에 하나는 텍스트라는 공간 하나는 이미지라는 공간만 빼고는 그 거리만 빼고는 나머지는 동일한 위치에 있게끔 계속 이제 학습을 시켜 주는 것이죠
29:44그러고 나서 하나는 소프트맥스로 얘가 로스를 구하는 것이고 하나는 시그모이드로 로스를 구하는 것이 시그립이에요
29:50그 이제 여기 구글이 이제 2023년도에 이제 발표를 했고요
29:57이렇게 해서 얘는 이제 더 간단한 학습 구조로 클립보다 효율적이고 대규모 데이터에서 강력한 성능을 보인다
30:04그래서 여러분들이 아마 VLM을 하게 되면은 클립이나 시그립을 이제 볼 수가 있고요
30:09그다음에 이제 그러면 인코더에 해당되는 이미지 인코더는 뭐 Vit, VAT나 레스넷 혹은 이제 디노 이런 것들이 이제 인코드 역할을 하게 되는 것이고요
30:24그다음 인코드를 통해서 나온 것들을 이제 클립을 통해서 이제 이미지 공간과 텍스트 공간이 일치하도록 계속 이제 학습을 대량의 데이터를 학습을 시키는 거예요
30:35계속
30:35그러면 이제 제로샷도 여기서 나오고 제로샷이라는 거는 학습하지 않은 것들도 이제 알아 알아맞추게끔 해 주는 것이 이제 이런 부분들이 해당됩니다
30:46자, 그다음에 이제 VLA 컨셉에서 용어는 이제 저희가 이제 밑에 단에 이제 해당되는 것이죠
30:52이렇게 해서 우리가 이제 학산 모델을 쓰게 돼요
30:59우리가 이제 전통적으로 이제 생성형 모델에 해당되는 것이 겐이 있고 그다음에 VA가 있고 그래서 VA는 실질적으로 우리 ACT 이런 쪽에 이제 많이 쓰였던 거고요
31:05디퓨전 폴 디퓨전 모드 모델은 디퓨전 폴리라고 해서 우리가 이제 그 VLA 이전에 아까 이제 트레토리 기반에 이제 그 어 이제 트레적 생성하는 곳에서 썼는데 요것이 이제 하부 단으로 들어간 거예요
31:24결국에 이제 VLA 하부단 즉 이제 밑에 롤레벨단을 결국은 이제 얘가 차지하고 있는 이제 그런 상태 결합이 된 거죠
31:36이제 액션 단위로만 처리된 것을 밑에 단을 이제 어 여기서 보시면 이제 학습 모델로 하는데 그중에서 이제 뭐를 쓰느냐? 플로 매칭을 써요
31:43그래서 플로우 매칭의 장점은 딱 이제 일단은 단단적으로 말씀 두 가지입니다
31:50일단은 빠르다
31:50그래서 이제 계속 이터레이션 디노이징을 해서 계속 이터레이션 하는데 만약에 이제 일반적인 디퓨전 폴리시는 한 1천000번 정도를 수행해야 되는 것인데 얘는 이제 100번 정도만 이렇게 수행하면은 이제 실질적으로 이제 디노이징을 해서 이제 노이즈가 없는 트레적토리를 구성을 할 수 있도록 해 줍니다
32:08그다음에 디퓨전 폴리시는 스토캐스틱이에요
32:15그래서 이제 약간 이제 계속 할 때마다 달라질 수가 있고요
32:15근데요 플로우 매칭은 어 디터미스틱합니다
32:22그래서 얘는 이제 어떤 일정하게 같은 형태로 동작을 하도록 그래서 지금은 이제 결국 결국은 디퓨전 이제 플로 매칭 형태로 이제 처리를 하고 있고요
32:34개념적으로 봐서는 얘는 확률적인 거리를 보는 거죠
32:34즉 이제 노이즈의 노이즈의 어떤 확률적인 거리가 위치가 있고 그다음 실제 이제 원래 그 목적하는 곳에 거리가 있는데 직선 거리를 구하는 거는 KL 다이퍼전스잖아요
32:54근데 실제로 이제 우리가 평면이 아니기 때문에 어떤 평지가 아니기 때문에 얘는 실제 직선 거리로 갈 수가 없어서 매 스텝마다 미분을 해서 그때 이제 방향과 속도를 구해요
33:06그래서 방향과 속도가 제일 좋은 놈을 선택해서 얘가 이제 그걸 적분하게 되면은 내가 원하는 트레토리가 나와요
33:11그 트레토리를 통해서 얘가 이제 그걸 이제 플로우 매칭이라고 합니다
33:17이렇게 해서 이제 그렇게 해서 이제 얘가 해당되는 위치로 즉 이제 노이즈가 없는 상태로 이제 가게 되는 거죠
33:24출발할 때는 이런 식으로 노이즈가 이게 이제 화이트 노이즈죠
33:24이제 가오시안 노이즈
33:30그럼 얘가 이제 실질적으로는 원래 이제 하게 되면 이쪽 길 이쪽길 각 스텝마다 미분해서 다음 거 미분해서 방향하고 속도 구하고 그다음 이런 식으로 해서 결국은 내 원래 그 오리지널 트레토리를 구해낼 수 있는 이런 형태로 진행하는 것이 이제 플로 매칭이라고 볼 수가 있습니다
33:48자, 여기까지가 이제 기본적인 어떤 실질적으로 VA 하기 위해서 이제 여러분들이 기본적으로 알아야 될 L&M 레벨에서 알아야 될 것들, V에서 알아야 될 것들 그다음에 이제 예 아, V, VLM, VL 이제 요런 식으로 이제 쭉 이제 요소들을 한번 봤고요
34:09요런 것들을 조합해서 이제 모델들이 이제 하나씩 나오기 시작합니다
34:15그럼 여러분들 요걸 가지고 이제 나중에 하나씩 보시면 되겠고요
34:20어 그다음에 이제 뭘 해야 되면 데이터셋들이 중요하죠
34:20어, 결국 이제 어쨌든 LNM에서는 아까 사전 학습을 한다든가 그다음에 파인튜닝을 한다든가 이럴 때 다 데이터셋들이 필요하기 때문에 그러면 이제 로봇 쪽은 어떤 것인가, 어떤 데이터셋들이 필요한가 할 정도를 잠깐 좀 보도록 하겠습니다
34:38그래서 저는 사실은 LNM이 로봇에 그렇게 바로 적용될 거라고 생각을 하지 못했어요
34:38왜 그러냐면 약간 이제 이런 데이터셋이라든가 이런 것들이 사실은 방 어떤 방대한 데이터를 모아야 되는데 그런 부분들이 과연 될까라고 봤었는데 아마암리의 그런 작업들이 이제 이루어진 것이죠
34:57어 자 그래서 이제 보시면 아까도 말씀드렸듯이 LNM은 텍스 텍스고요
35:05그래서 이제 보면은 뭐 GPT, 라마, 제미나의 팜 그다음에 이런 어떤 잼마 우리가 이제 팜이나 잼마 이런 것들은 이제 실제적으로 쓰이니까 요걸 한번 기억해 두시고요
35:16그다음에 라마도 이제 쓰이죠
35:16하나, 둘, 세 개
35:16그래서 람 이제 VLM은 요걸 가지고 다시 이미지를 붙여서 이미지 텍스트를 통해서 텍스트 나오고 그랬을 때 파미라든가 프리즈마틱 세세비 그다음에 파리겟마 그다음에 VLA를 통해서 얘가 이제 오픈 VLA 그다음에파0 RT2 이런 식으로 이제 만들어지게 되는 것입니다
35:42그래서 실질적으로 이제 요게 LNM 레벨이죠
35:42그래서 팜투를 가지고 얘가 이제 파리 X 파리 이건 두 가지 모델을 썼어요
35:57VM 55비 빌리언 그다음에 12 빌리언짜리 굉장히 모델이 컸죠
35:57여기 보시면 어 프리즈마틱 VM램은 7 7비 7빌리온으로 내려갔어요
36:05그다음에 파리 파리만은 EB로 내려갑니다
36:11그다음에 이제 스몰 VL는 뭐 이제 0
36:173 3비 뭐 이런 식으로 이제 계속 경량화 과정을 계속 거쳐요
36:17그러니까 LNM은 계속 이제 사이즈가 커지는데 실질적으로 이제 VLM 같은 경우 VLA 같은 경우에는 어쨌든 이게 임베디 시스템이 들어가야 되다 보니까 나름대로 계속 사이즈를 줄여 나가는 그런 과정을 거치게 되는 것이고요
36:39그다음에 LNM VLM 계열에서는 이제 파리마 프리즈마틱 VLM 어 파리겐마 이런 식으로 돼 있고요
36:45이걸 통해서 만든 VLA가 RT2 그다음에 어 오픈 VLA 그다음에 파일 이런 식의 어떤 컨셉을 여러분들이 잘 이해를 하고 계셔야 그냥 단순히 그 V 하면 그냥 끝나는게 아니고 lnm을 어떤 걸 썼는지 그러면 그 그 속성들이 사실은 배어 있는 거예요
37:04그 그런 속성들을 알고 있으면 사실은 여러분들이 아 얘는 이런 이런 성격을 갖고 있겠구나 하는 것들을 이제 자동으로 이제 알 수가 있는 것이죠.음 음
37:17그래서 사실은 이제 어 VLA가 가능했던 거는 오픈엑스 인디 인바디먼트 데이터셋이 사실은 존재했기 때문에 어 VLA 개념으로 넘어오게 된 겁니다
37:29이게 엄청나게 방대한 데이터셋을 어 여기 뭐뭐 유시 버클리 구글 딥마인드 CMU 그다음에 어 콜롬비아 대학 등에서 굉장히 대규모 데이터셋을 로봇용으로 모았어요
37:47물론 이제 LNM처럼 그런 프리 트레이닝 할 때처럼 아주 방대한 데이터는 아니더라도 그래도 아주 이제 굉장히 많은 데이터셋이 모아진 것이죠
37:55그래서 이제 비전 랭게지 액션 기반의 모델의 범명성 일반화 그래서 이게 이제 얼마나이 데이터셋이 많으냐에 따라서 범형성의 관계가 있어요
38:08데이터셋에 양이 많을수록 범형성은 좋아져요
38:08그다음에 일반화 성능을 키우기 위해서 만들어졌으면 최근 발표 발대표 모델인 오픈 VA 옥토 그다음 파이즈 다 VLA요 지금 오픈엑 인바디먼트 데이터셋을 이제 사용을 했습니다
38:27그래서 지금 보시면 어 로봇 수가 22개 기간에서 150종 이상의 로봇이 일단은 여기서 데이터셋을 다 수집을 한 거예요
38:34굉장히 많은 로봇들이 실질적으로 데이터 수집이 된 것이고요
38:41그다음에 500m 이제 500m 프레임스 시퀀스가 이만큼 엄청나게 많은 데이터셋
38:52여러분들이 아마 이거를 한 사람이 만들고자 하면은 고작 몇 개뿐이 안 되죠
38:52근데이 이렇게 많은 방대한 데이터를 사실은 여러 개의 그 기간에서 다 모아 놓은 것이고요
38:57그다음에 이제 작업수가 527개야
39:05뭐 이렇게 픽앤 플레이스 뭐 해서이 종류가 527개 굉장히 그 그럼 로봇이 웬만큼 할 동작들은 여기 다 있다라는 거죠
39:16527개 동작들을 이제 한 거니까 이렇게 해서 여기가 지금 보시면 이제 레벨 라벨 형태로 해서 이미지 자이너 그다음 액션들에 대해서 그럼 이걸 가지고 이제 아까 이제 VLM에서 이제 그 액션 익스포트 액션을 하는 기능을 가지고 통합해서 이거를 이제 학습을 시켜 주는 거죠
39:31이걸 통해서 프리트레인을 하는 거야
39:31예
39:39이게 이제 오픈 소스로 되어져 있다
39:39그래서 지금 보시면 요게 이제 빨간색이 데이터셋, 노란색이 데이터 굉장히 이제 이런 데이터셋, 저런 데이터셋이 이제 계속 모여졌다
39:44이제 월드 와이드하게 뭐 이런 어떤 의미를 띄고 있어요
39:51자, 그래서 이제 많은 데이터셋이 이제 여러 다양한 정 그 이걸 이제 우리가 오픈엑 인바디먼 데이터셋이라고 하고 그다음에 이제 로봇이 있어요
40:04로봇에다이 옷을 입힌 거 학습 사전 학습을 시켰다라는 거야
40:04사전 학습시켰고 그렇게 해서 이제 내가 이제 사전 학습된 걸 가지고 이제 일을 한다라는 컨셉으로 이렇게 이제 이미지가 쭉 나온 겁니다
40:24자, 주요 특징들은 이제 다양한 로봇 환경 통합을 했어요
40:24엄청나게 많은 뭐 이렇게 아까 이제 한 어 150종이니까 웬만한 로봇들 뭐 협동 로봇이나 일반적인 로봇들은 여기 다 포함이 되어 있다라고 볼 수가 있고요
40:35범형성 목표 그래서 얘는 범형성을 목표로 하고 있습니다
40:35근데 아까처럼 이제 나름들 비슷한 환경에서는 이제 어느 정도 학습만 되면 그것을 이제 할 수 있도록 해 주는 그다음 명령어 중심 데이터 구성을 했고 멀티모델 구성을 했습니다
40:46그다음에 이제 학습에 적용될 모델은 이제 오픈 V, 옥토 그다음에 이제 파이 이제 실제로 이제 유명한 데이터들은 로봇들은 여기 이제이 오픈엑 X 오픈엑 X 인바디먼트 데이터셋을 다 활용을 했다라고 볼 수가 있어요
41:04그다음에 이제 브릿치 데이터 버전 2라는 것은 뭐냐면 이제 유시 버클리에서 만든 연구 팀에서 만든 것이고요
41:11이제 로봇 데이터 조작 여기서는 이제 결국 평가하고 벤치마킹 할 때 이제 보통 많이 사용이 되는 거 아까는 사전 학습할 때 사용되었던 것이고요
41:25실제로 이제 얘가 이제 사전 학습을 다 하고 나서 뭐 파인튜닝하고 나서 얘가 성능을 이제 서로 비교를 해 봐야 되는데 그때 이제 사용되어지는 것이 뭐냐면 브릿지 데이터 브트라는 것을 통해서 근데 여기서 이제 약간 이제 이제 여기서 위도우 X25라는 것은 뭐냐면 아 알로아 모바일 알로아에 써 있던 로봇 있죠? 그 그 저기 뭐죠? 로보티즈에서 만든 그 로봇 그걸 이제 사실 얘가 로봇의 종류가 많지 않아요
41:50아까 이제 오픈엑 인바디먼트는 한 150 아까 이제 엄청나게 많은 로봇들이 다 해서 범형성이라는 거죠
41:55그런 것들이이 이런저런 로봇들을 다 해서 처리한 건데 얘는 그냥 딱 몇 개의 종류뿐이 안 되고 그러다 보니까 얘는 이제 실질적으로 어 약간 이제 일반화 성능 평가용 벤치마크를 할 때 이제 요걸 많이 사용한다 정도를 이렇게 보시면 되겠습니다
42:20자 이렇게 해서 이제 실질적으로 이제 우리가 어떤 이제 기본적인 기능이나 이제 데이터셋의 기본적인 것들을 쭉 봤고요
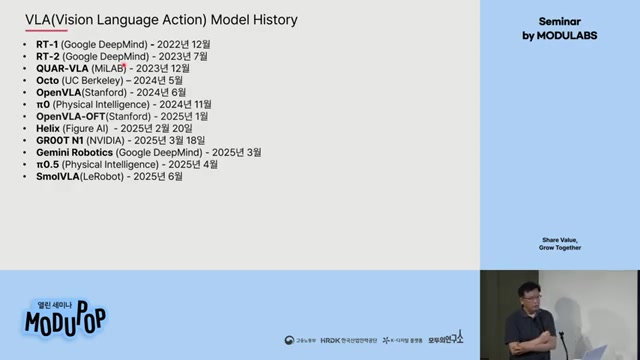
42:27그럼 이제 모델별로 이제 어떻게 진화를 해 나갔는지를 한번 쭉 살펴보도록 하겠습니다
42:27그래서 하나, 둘, 셋, 넷, 다섯, 여섯, 일곱, 여덟, 아홉, 열나, 12, 12개 정도
42:34현재 지금 사실은 이제 2012년도부부 22년도부터 해서 지금 2025년도 6월이면 별로 한 갭이 없, 별로 안 되죠
42:47한 3개월 정도 갭 사이에 지금 한 12개의 모델이 나왔어요
42:53그러면서 엄청나게 빠르게 변화를 한 거죠
42:59그럼 여기서 이제 요렇게 나열한 것은 뭐냐면 그때그때마다 어떻게 바뀌어졌는지를 여러분들이 쭉 이제 살펴 보는 것들이 중요하다라는 것이고요
43:06어떤 기능이 어떻게 계속 추가됐는지 이런 부분들이 이제 중요한 것이고요
43:14어 여기서 일단은 보시면 RT1 RT2 그다음에 이제 오픈 VLA파0 그다음에 오픈 VLA OPT 그다음에 파파 파.요 요 정도가 일단 여러분들이 메인스트림으로 쭉 보시면 전체 흐름이 어떻게 되어졌는가를 이제 알 수가 있지 않을까 생각을 합니다
43:29그래서 2 실제적으로 이제여 세상에 나온 거는 오픈 VLA부터 그 전까지 비공개 소스나 이런게 비공개였고요
43:43그래서 스탠포드에서 박무진이란 분이 김무진이죠
43:50그래서 김무지라는 분이 이제 2024년 2024년도에 곧 어 6월 달이죠
43:56그러면 한 1년 얼마 안 되죠
43:56근데 그 사이에 이제 사실은 엄청난 변화가 생긴 거죠
44:03재상이 공개되고 난 이후에 그니까 물론 이제 RT1, RT2는 2023년도 여기서 최초로 이제 VA라는 용어가 이제 어디 어디서부터 사용되어졌냐면 2023년도 요때 이제 RT2부터 이제 VLA라는 용어가 정식으로 사용이 되어진 거고요
44:28그다음 세상에 이제 이것이 나온 것은 2024년도 불과 1년 사이인 거죠
44:34그 짧은 시간에 사실은 엄청난 이제 변화가 이제 있었다라는 것입니다
44:40그다음에 이제 여기서부터는 이제 2025년도부 들어오면서부터는 본격적으로 이제 휴먼노이드에 이제 쭉 적용이 되는 그런 부분들로 이렇게 보게 됩니다
44:54펠릭스라든가 프론트 앤원이라든가 그다음에 제미나의 로봇 이런 쪽은 다 휴먼노이드에 적용되 있는 그런 이제 용 VLA다라고 볼 수가 있는 것입니다
45:06그래서 이제 VA 대표 모델에서 이제 첫 번째로 보시면 이제 어 쭉 보죠
45:12자, 여기서 보시면 이제 사전 학습을 쭉 하는 거예요
45:19이제 어떤 텍스트 텍스트 영상 그 VLM이 됐어요
45:19그다음 다시 얘가 이제 RT1을 삼켰어요
45:26그렇게 해서 RT2가 나온 거예요
45:26이런 식으로 이제 아까 LNM, VLM 그다음에 이제 VL 이런 과정을 이제 거친 것이다라고 이렇게 이제 볼 수가 있는 것입니다
45:37그래서 이제 보시면 두 가지 VLM을 썼어요
45:378X하고 8m
45:43어, 8
45:438이라고 해서 얘가 이제 하나가 얘가 하나가 12M고 얘가 이제 12M 그다음에 얘가 8x가 55 55B 메가가 아니 B죠 빌리언이죠 모델이 얘는 지금 보시면 번역 이제 텍스트하고 비디오까지 해서 번역하는데 특화돼 있는 모델을 썼어요
46:03그 얘기는 법형성이 굉장히 좋다는 얘기고요
46:03얘는 로봇 용으로 사용돼서 CB 렇게 해서 이제 사용이 되어져 있던 VLM입니다
46:10근데 실질적으로 이제 여기서 RT1은 보면은 이제 VLA가 아니에 트랜스포머를 쓰고 그다음에 이제 필름이라고 하는 것은 이제 영상이나 텍스트를 정합하는 거야
46:24조건으로 들어가는데 그 조건이 아주 이제 강하게 걸릴 수도 있고 약하게 걸릴 수도 있어
46:32조건을 내가 어떤 조건을 줬는데 조건이 이제 보통 컨 컨테쳐 버리면 조건이 말을 안 들어요
46:38그냥 조건을 무시해 버려요
46:38그래서 여기서도 여러분들이 보실 때 이제 아 조건을 어떻게 강하게 넣어 줄 수 있느냐 하는 부분들이 굉장히 중요합니다
46:45그래서 내가 조건이라는 건 뭡니까? 여러분 언어라든가 비디오에서 나름대로 그런 어떤 컨디션을 줘야지 내가 그거대로 행할 수가 있는데 그 조건이 제대로 안 걸리면 얘가 엉뚱한 일을 하거나 이렇게 됩니다
47:04강하게 조건을 걸어 주는 인터페이스라고 볼 수가 있습니다
47:04그래서 이제 필름이라는 인터페이스가 있고요
47:10아까 이제 보시면 이제 트랜스포머 트랜스포머에서는 이제 크로스 크로스 어텐션 인터페이스가 있고 그냥 간단하게 컨캐시라는 인터페이스 굉장히 인터페이스들이 많습니다
47:17이런 조건을 걸어 주는 것들이 어 그럼 이제 어떤 인터페이스이냐에 따라서 사실은 이제 아이가 결합성이 좋다 나쁘다를 사실은 이제 볼 수가 있어요
47:31여기서 파리 이제 필름도 굉장히 좋은 이제 결합성을 갖고 있고요
47:37그냥 트랜스포머를 통해서 그냥 간단하게 그냥 처리해 주는 요런 형태로 되다가 이제 RT2부터는 아예 LNM이 추가가 추가가 돼서 이제 아까처럼 VLM 그다음에 VLA 개념 여기서부터 이제 RT2부터는 이제 VLA라는 그런 부분들이 공식적으로 이제 사용이 되기 시작한 이런 부분들이다라고 볼 수가 있습니다
48:00그래서 이제 RT1을 보시면은 그냥 여기서 똑같이 진행이 되는 거죠
48:08이렇게 해서 얘가 명령을 주고 그다음에 조건 이제 언어하고 그다음에 이제 예비 비디오의 조건을 주는 거야
48:15조건을 주게 되면 얘가 이제 동작이 돼서 얘는 토큰 러너는 약간 사이즈를 줄여줘요
48:20좀 사이즈를 줄여주는 역할을 하는 것이 토큰 러너고 트랜스폼을 통해서요 지금 해당되는이 조건들에 해당되게끔 뭔가 동작을 하도록 액션 단위로 출력이 됩니다
48:31여기서는
48:31그다음 엑도 보면 두 가지가 있어요
48:37오픈 루프가 있고 그다음에 크로스 크로스 루프가 있어요
48:37오픈 루프는 그냥 딱 어디에 있다라고 하면은 그냥 무조건 거기까지 가는 거예요
48:44물론 그게 정확하지 않더라도 얘는 보정이 안 돼요
48:44근데 크로스 루프는 어떻게 되느냐? 내가 이제 실제적으로 이제 비전으로 보거나 이렇게 해서 약 자기가 이제 가고자 하는 방향을 수정할 수 있는 것이 이제 크로스 루프예요
48:57현재 이제 RT1과 RT2는 그냥 오픈 루프를 통해서 액션 처리했기 때문에 정확성이 떨어집니다
49:03그런데 이제 RT2부터는 이제 뭐냐면은 이제 크로스 루프를 통해서 내가 이제 약간 이제 약간 이제 어떤 델타값들 이제 보정값들을 줘서 내가 원하는 곳까지 이렇게 초정이 가능하도록 만들어 준 것이 이제 VLA예요
49:22VLA는 이제 그런 쪽에 롤레벨에서 약간 이제 그런 부분들이 보강이 돼서 좀 더 이제 정확성을 좀 높혔다 정도로 일단 이해하시면 되겠고요
49:29자, 여기서도 마찬가지
49:29이제 하나는 전통적인 전통적인 로봇이고요
49:36하나는 이제 RT1이라는 것은 뭐냐면 데이터셋시에 따라서 내가 이제 굉장히 다양한 행동을 할 수 있다
49:42근데 전통적인 로봇은이 데이터셋과 상관없이 그냥 일을 한다
49:47요걸 이제 그림으로 이제 표현을 해 준 겁니다
49:58자, 그러면서 이제 VLA에 적용이 된 것은 뭐냐면 알티투아에다가 여기서 이제 파이라는 것을 전단에 둔 거예요
50:10요게 이제 바로 VA로 들어가기 직전이죠
50:10이제 아까는 그냥 어 RT1에서 바로 명령을 줬는데 여기서 이제 내가 리프트더 커피 컵이라고 하면은 파리에서 뭐 이제 요걸 세부적 나누죠.를 이를 그러면 이제 컵을 짓기 위해서는 무브트 그립투 핸들 손잡이로 가야 되고 그다음에 손잡이를 잡아야 되고 그다음에 라이즈 업도 그래서 들어야 되고 자 이런 식으로 그러면 요거를 다시 이제 얘가 RT1에다 주는 그니까 바로 이제 VVLA의 전 단계에 해당됩니다
50:48요것이 이제 RT2는 아예 이거를 아까 통합해서 VLA 컨셉으로 이제 만들어 주게 된 것이죠
50:54자, 여기서 이제 어쨌든 여기서 보면 8이라는 것을 썼어요
50:548를 VLM이죠
51:01VLM을 써서 이제 해당되는 기능들을 이제 만들어 주고 그다음에 거기 RT1에다 집어넣은 거죠
51:07아까 이제 여러분 보셨듯이 얘가 이제 맨 처음에 텍스트 훈련 받고 비디오 훈련 받고 그 RT1을 먹어 먹어 나니까 RT2가 됐다
51:14뭐 이런 식의 어떤 이미지가 나왔듯이 동일하게 얘가 이제 그래서 RT2는 이제 여기서부터가 진정한 이제 VLA의 시작인 것이죠
51:21그래서 이제 여기서부터 이제 어 VLA가 이제 실질적으로 이제 바로 이제 여기서 바로 이제 아까 VLM에 그다음에 이제 토큰 토큰이 이제 아까 여기에 보시면 액션 토큰이 바로 그냥 바로 연결돼 있는 그다음에 이제 요게 변형이 되면 이제 디퓨전 컨셉을 해서 플로 매칭에 붙어서 이제 트레토리 컨셉으로 나오는 좀 더 계속 진화가 되는 것이죠
51:49현재는 그냥 바로 엑선 단위로 처리하는데이 액션도 그냥 오픈 루프예요
51:56오픈 루프니까 그냥 얘가 토큰에서 위치를 알려주면 아 그냥 위치로 가서 처리합니다
52:02보정 없이 이렇게 되는 것이 이제 알티라는 컨셉의 기본 개념이에요
52:14자 그다음에 이제 사정 로봇에서도 이제 보통 여러분들이 그냥 암에만 적용되는 것이 아니고요
52:19이제 나중에 주행도 사실은 VLA로 다 통합이 될 거 같아요
52:19엔드 엔드로 하기 때문에
52:25그래서 실질적으로 이제 향후에는 일반적인 어떤 로봇과 주행과 그런 것들이 다 통합이 돼서 그냥 명령만 하면은 어디 위치로 가서 그다음에 어 뭘 하고 뭐 이런 것들이 실질적으로 이제 다 통합이 되는 이제 그런 컨셉으로 이제 볼 수가 있고 여기서는 이제 VLA 커드 쿼드 VLA라고 했는데 사실은 VLA가 아니에요
52:46여기서 보면은 얘도 지금 보면은 RT1처럼 트랜스포머 기반으로 이제 만들어진 겁니다
52:53그리고 여기서는 이제 특이한 것이 실세계하고 그다음 합성 데이터를 혼합해서 썼어요
52:59지금 이제 M비디어에서 이제 보통 많이 하고 있는 실시간 이제 어떤 가상의 어떤 이미지라고 하듯이 여기서도 이제 그런 것들을 통해서 했다.요 정도만 일단은 정리하고 얘는 그다음 옥토라는 것도 있어
53:1360 어클리 옥토도 있는데 요것도 이제 그냥 요것도 트랜스포머 기반이 아직은 VLA라고 볼 수 없는 거고요
53:20그다음에 오픈엑 인바디먼트를 썼고요
53:20그다음에 이제 토큰 단위로 이제 토큰인데 토큰 토큰 단위로 이렇게 움직이도록 합니다
53:27음
53:27자, 넘어갑니다
53:38자, 일단 스탠포드에서 나온 이제 오픈 어 VLA가 이제 여기서는 아까 말씀드렸듯이 액션이 이제 크로즈 루프로가 바뀌었고요
53:46그다음에 아까 이제 모델이 55비 12B 해서 이제 7비로 낮아졌어요
53:59라마를 썼어요
53:59라마를 쓰고 그다음에 이제 그 라마에다 VLM을 만든 것이 어 프리즈마틱 VLM이에요
54:07프리즈마틱 로봇용으로 이제 얘가 프리즈마틱 VM을 이제 만들었고 액션 디코더를 통해서 얘가 이제 처리하도록 하는 VLA가 이제 만들어지게 된 겁니다
54:13근데 이제 속성에서 보면은이 얘는 오픈 브에는요 여자에다가 이제 콜라를 넣어라 그러면은 오픈부를 못 해요
54:24범형성이 떨어지는 거예요
54:32왜 그러냐면 아까 이제 그 오 저기 RT2는 55B 그다 12비 굉장히 범형성이 좋은 LNM을나 VLM을 썼기 때문에 얘는 이제 이런 어떤 것들을 할 수가 있는데 얘는 지금 보면은 이제 그런 것들이 떨어져요
54:51그러니까 여러분들이 딱 봤을 때 어떤 걸 써서 아까 이제네 가지 어떤 속성에서 어떤 컨셉이 얘는 이제 잘 적용이 됐다 안 됐다를 사실은 이제 그 L lnm이나 VLM VL의 어떤 어떻게 만들어졌는가를 보게 되면 이제 대략적으로 이제 알 수가 있는 그런 부분들이라고 볼 수가 있습니다
55:11자 이렇게 해서 얘는 지금 보면은 얘는 아까 세 볼일 한 거죠
55:18그래서 이제 처음에 LNM을 한번 이렇게 프리트닝하고 파인 튜닝하고 RL하고 그다음에 VLM에서도 다시 파인 튜닝하고 사전 학습하고 그다음에 그거 동일하게 하고 V에서 세 번 V를 하고 놨기 때문에 반은 먹고 얘는 그래서 반은 동작을 해요
55:31그냥 처음 이렇게 딱 놔두고 그런 이제 파인 튜닝을 통해서 좀 더 이렇게 오버피팅 하는 거죠
55:36해당되는 것에 딱 적하게 이제 일을 할 수 있게끔 하게 됩니다
55:44아까 말씀드렸듯이 사전 학습은 굉장히 방대한 아까 오픈 오픈엑 이제 인바디먼트도 모자라서 더 이제 데이터를 만들어요
55:57그러면 그것만큼 성능이 나오는 거예요
56:03범형성이라든가 이런 것들 포함해서
56:03예
56:03그리고 나서음 어 이제 그런 여러 가지 부분들이 이제 복합적으로 이제 깔려 있다라는 것을 이제 여기서 쭉 그다음에 그래서 이제 아웃 오브 dist스b션이 뭐 아 o가 있고 아 o가 있어요
56:22OB는 뭐냐면 파인튜닝 하기 전에 이제 실질적으로 얘가 성능이 얼마나 좋은가를 보는 것이 OOB고요
56:29OD는 뭐냐면 내가 학습하지 않은 것까지 내가 학습을 하는 능력을 이제 보여 주는 것이 이제 OOD에 해당됩니다
56:36이런 어떤 오픈 VLA는 얘가 이제 아까 말씀드렸듯이 최초로 이제 VLA가 전체 공개가 된 거죠
56:432024년도에 아까 이제 RT1과 RT2는 공개가 되지 않았어요
56:49그렇지만 얘가 이제 2024년도에 이제 공개가 되면서 근데 제가 이제 이분이 이제 실질적으로 한시간 정도 이렇게 그 이제 인터뷰를 한 거를 쭉 제가 이제 쭉 따서 다 이제 들어봤는데 엄청나게 많은 테스트를 진행했었어요
57:02여러 가지 면에서 이제 그런 부분들이 뒤쪽에 나오긴 하는데음 여기서 봐듯이 얘는 이제이 여자에다가 콜라 이거는 이제 배우지 않은 걸 본 거야
57:14OB죠
57:14OBOD의 능력을 보는 거죠
57:21이렇게 해서 이제 그리고 나서 어 RT2X는 얘가 범형성이 좋기 때문에 여기다 놓지만 오픈 X 오픈 VL에는 범행성이 떨어진다 보니까 해당되는 곳에 잘 들어가지 못하 정확성은 좀 좋아졌죠
57:32왜 그러냐면 아까 이제 크로즈 루프를 통해서 했기 때문에 정확성은 좋아졌지만 범형성은 좀 떨어진다
57:39근데 경량 됐죠
57:39아까 경량화는 이제 아까 이제 보면은 어 55비b비 70 12b비b비를 쓰던 거를 7비를 쓴 거죠
57:52그다음 속도나 이런 것들 이제 실시간이나 이런 것들도 이제 따져 봐야 된다라고 했어요.네 가지 정 측면을 이제 쭉 봐야 되는데 그래서 지금 보시면 얘는 지금 보시면은 얘가 라마 27B를 썼고요
58:05그다음에 프리즈마틱 VLM을 써서 이제 영상 디노트를 썼어요
58:12얘가 이제 디노트는 실질적으로 이제 메타 계열이죠
58:17메타에서 나온 계열들을 쓰다 보니까 이제 디노트나 C그립 이런 것들을 통해서 영상 입력 아 영상과 텍스트 조합 이런 식으로 합니다
58:24그래서 영상과 텍스트 조합도 있고 영상을 바로 내가 해서 조건을 집어넣는 것도 있고 그래서 두 가지 인코더를 쓴 거죠
58:31그래서 클 시그립을 쓰느냐 디노트를 쓰느냐 이런 부분들에 해당되는 것들이 여기서 VLM에 해당되는 것이고요
58:38그다음에 이제 데이터셋은 이제 오픈엑스 인바디먼트를 쓰게 된 것입니다
58:44이렇게 하고 이제 트레인드 뭐 여기서 더 한 거죠
58:5115 뭐 데이터셋 이런 것들 그러니까 요것까지 하고 나서 더 추가한 거죠
58:51이렇게 해야지만이 조금 더 이제 학습 능력을 더 가지게 되는 것이고요
58:59그다음에 이제 VNA 개념에서는 이제 아웃풋을 얘는 이제 크로즈 루프을 써서 내가 해당되는 토큰을 가지고 이제 어떤 위치나 자세 이런 것들을 가지고 이제 액션 단위로 이제 크로즈 루프를 해서 처리하기 때문에 조금 더 얘가 이제 실제 이제 보정을 해가면서 처리할 수 있도록 만들어지게 된 것입니다
59:23자, 그다음에 다양한 로봇을 테스트해 본 거죠
59:30굉장히 다양한 이것도 이제 범형성 로봇의 범형성에 해당됩니다
59:30그래서 이제 어떤 특정한 것만 하게 되면 이제 범행성이 떨어질 수가 있습니다
59:37이런 다양한 것들을 실험해 봤고 그다음에 풀리 오픈 소스예요
59:42그래서 여기서부터가 이제 그래서 이제 V 오픈 VL가 굉장히 각강을 받기 시작한 거죠
59:47그때 당시에 불가 사실 1년 전이에요
59:47예
59:47이게 근데 벌써 이제 완전히 판도가 또 바뀐 거죠
59:54예
59:54그래서 이제 여기서 실험을 이제네 가지 측면에서 했어요
01:00:00그래서 첫 번째가 이제 오픈 V에서 OB 아웃 오브 박스 이건 그냥 파인 튜닝하기 전에 파인 튜닝하기 전에 이제 어떤 능력을 보는 것이고 그다음에 이제 VLA 이제 바인 튜닝 하고 나서 이제 이제 테스트를 해 보고 그다음에 이제 보시면 어 로라 로라를 통해서 이제 파인트닝을 했을 때 그니까 파인튜닝 하는 방법들 여러 가지가 존재합니다
01:00:25lnm 여러분 아시는 분은 아 로라가 뭔지 이런 부분들 그니까 로라로 해서 파인티닝 할 것인지 아니면 전체 모델 다시 한번 파인트닝 할 것인지 이런 옵션을 줄 수 있듯이 여기서도 로라로 이렇게 파인튜닝을 할 수가 있다라는 것이고요
01:00:38그다음에 어 여기서 이제 퀀타이제이션을 합니다
01:00:44마찬가지로 이제 사이즈를 줄이기 위해서 이제 퀀이제이션을 이제 이런 식으로 이제 여기서는 굉장히 다양한 테스트를 이제 진행을 이제 했한 거 같아요
01:00:58그래서 요런 것들이 여러분들한테 아마도 이제 도움이 이제 나중에 테스트할 때 도움이 되지 않을까? 그래서 여기서는 이제 시각적 일반화를 테스트해 봤고 그다음에 동작의 일반화 그다음에 물리적인 일반화 그다음에 의미적인 일반화 그다음에 그 언어가 어떤 내가 동작을 하도록 해당되는 동작을 잘하는지 못하는지 이게 이제 그 랭귀지 그라운딩이라고 합니다
01:01:25그래서 이제 비주얼 제너럴라이제이션은 뭐냐면 내가 이제 색깔이 바뀌든지 크기가 바뀌든지 했을 때 이제 어떤 시각적으로 변화했을 때 잘 적응하느냐 안 하느냐에 대한 것들을 테스트해 본 거고 어 모션의 일반화은 내가 이제 내가 학습한 범위 밖에까지 이제 처리하도록 이제 해 준 부분들이 그 모션의 일반화에 해당돼요
01:01:50그다음에 이제 피지컬 물리적인 일반화는 뭐냐면 내가 이제 냄비인데 같은 냄비인데 사이즈가 다른 냄비를 줬을 때 얘가 그거를 잘 짓고 하느냐 하는 부분들을 테스트해 본 거고요
01:02:04그다음에 세틱 어떤 명 어떤 의미가 좀 다 이제가 내가 내가 실제적 훈련받지 않은 뭔가를 집어넣을 때 얘가 잘 그거를 짚느냐 안 집느냐를 테스트해 본 것이 세틱제너럴제이션이에요
01:02:15그다음에 이제 랭 랭게지 그라운딩이라는 것은 어떤 명령을 줬을 때 그 명령이 실제 잘 그라운딩 잘 이게 쭉 동작이 되는지 이런 부분들을 이제 처리하는 부분들이 이제 한 다섯 가지 정도의 이제 테스트들을 쭉 이제 엄청나게 많이 다양하게 테스트를 해 봤다는 것이 오픈 V의 또 장점인 거 같아요
01:02:38이런 부분들로 향후에도 테스트를 해 봐서 이런 부분 이제 이러 이러하다 정도를 이제 봐야 되는 부분들이고요
01:02:44그렇게 해서 이제 보시면은 여기 여기서 보시면은 이제 요게 이제 RT1 옥토 그다음에 RT2 그 실제로 얘네들은 V가 아니다 보니까 성능이 떨어지긴 하죠 얘네들은 그러면이 두 가지 중에 그럼 내가 이제 결국은 이제 RT2보다 좋다라는 것을 여기서 이제 표현을 해 준 거죠
01:03:05결국은 이제음 얘가 지금 보시면 비주얼 제너럴 레이션은 이제 얘는 87%예요
01:03:12색깔이나 이런게 바뀌어도 별로 영향을 안 받는다는 거예 얘는
01:03:12근데 어 RT2는 그래도 52% 성능 차이가 많이 나죠
01:03:19그다음에 이제 모션 모션은 이제 내가 훈련받지 않은 범위 밖에서 이제 훈련했을 때는 비슷비슷하게 나온 거고 그다음에 이제 물리적 형태 냄비가 이제 크기가 바뀌거나 형태가 바뀌어도 얘는 잘한다
01:03:33얘는 굉장히 크게 나온 거죠
01:03:33뭐 이런 식으로 이제 쭉 세티, 랭귀지, 그라운드 이렇게 결과적으로 봤을 때 토탈리해서 RT2보다 20% 좋다라는 결론을 이제 얻게 된 되어져 있 여기서 이제 그렇게 테스트가 진행이 됐다라는 것을 여기서 보여 주는 것이고요
01:03:50그다음 아웃브 박스입니다
01:03:50아웃브 박스라는 것은 뭐냐면 그냥 바로 파인튜닝 하지 않고 테스트한 거죠
01:04:03이것도 보면은 얘가 어 좀 더 좋다라는 것들을 쭉 이제 보여 주게 된 것입니다
01:04:08그다음 파인 튜닝을 하고 나서도 보시면 스크래치 아예 파인튜닝 아예 그냥 프리트레인 하지 않고 했던 거
01:04:13근데 프리트레이닝 하지 않으면 성능이 안 나와요
01:04:20반드시 대부분 프리트레이닝을 해야지만이 성능을 유지해야 된다라는 것이 파인팅을 해 봤자 별로 이렇게 성능이 별로 안 좋다 정도를 여기서 이제 쭉 나타내 주고 있습니다
01:04:33이렇게 해서 여기 보시면 어 파인튜닝 할 때 스크리치 스크래치 형태는 그냥 프리트레닝 하지 않은 거는 성능이 그렇게 좋지 않다
01:04:39반드시 이제 그런 부분들 규칙을 지킬 건 다 지켜야 된다는 얘긴 거죠
01:04:45우리가 이제 프리트레이닝 안 하면 대규모 사전 학습이 안 되면 실질적으로는 그거를 이제 그만큼 성능이네 떨어진다라는 것입니다
01:04:52그다음에 이제 어 파인튜닝할 때 어떤 것으로 하는게 좋으냐 로라로 하는 것이 좀 더 이렇게 낫다라는 것이 여기서 이제 여러 가지 테스트 중에서 어 이제 라스트 레이어 온니 그다음 프로즌 비전 그다음 스위치 뭐 이런 것들 중에 로라로 이렇게 파인튜닝 하는 것이 좀 더 성능을 좀 높여 준다 하는 것들을 여기서 이제 보여 주는 그런 장면들이고요
01:05:17그다음에 여기서 4비트 양자에 관련해서도 4비트 양자에도 이렇게 성능에 성능에는 그리도 이제 많이 영향을 미치지 않는다
01:05:24이제 이런 부분들까지도 굉장히 다양한 테스트를 VLA에서 쭉 해 봤다
01:05:30이것들을 나중에 벤치마킹 하셔서 이제 보시면 되겠고요
01:05:36그러면은 이제 이런 것들이 성능에서 좋아졌던 것들은 뭐냐면 약간 이제 아까 오픈엑스 인바디먼트 외에도 사전 학습을 뭐 15개 이상 뭐 이렇게 했다라는 거 하고 그다음에 정확성 같은 경우에도 보시면 아까 이제 오픈 루프에서 이제 크로스 루프로 이제 바꿔졌던 것들 이런 부분들이 조금 더 성능 향상을 높인 것에 기인하지 않았을까 이렇게 생각을 하고 있습니다
01:06:02그다음에 이제 우리가 이제 파이즈로 이제 오픈 V 이제 쭉 해서 쭉 넘어가도록 하겠습니다
01:06:09자, 여기서는 이제 어, 여기서는 이제 파이 의미는 플로 매칭을 처음 썼던 것을 이제 의미가 있어요
01:06:20이제 플로 매칭을 처음 썼다라는 것의 의미는 좀 더 정확해졌다라는 거죠
01:06:26정확성이 높아졌다
01:06:26그러니까 아까 액션 단위로 이제 처리했지만 여기서는 플로 매칭 기법을 써서 얘가 이제 실질적으로 이제 트레토리 단위로 이제 처리하도록 이제 만들어 주게 된 것입니다
01:06:38그다음에 이제 파리겐마 이제 VLM이 이제 3기 3비 정도 됐어요
01:06:43경량화도 됐고요
01:06:43그다음에 이제 범형성도 좋아졌어요
01:06:51여기서도 보면은 한 만시간 정도의 데이터를 더 확장을 한한 것입니다
01:06:57네
01:06:57이렇게 해서 이제 이런 다양한 이제 범명성이라 그래서 이제 결과적 성능이 더 이제 얘는 더 좋아졌다라는 것을 여기서 이제 보여 주고 있습니다.음 그래서 이제 얘가 이제 결국 이제 오픈 브레이하고 파이하고는 이제 약간 성능이 더 좋아진 부분들이 있다 하는 것을 여기서 이제 보여 주고 있는 거예요
01:07:17그 그거의 원인은 아까 이제 조금 더 사전 학습에서도 굉장히 그 자체로 한 만 시간 정도를 여러분들이 데이터셋을 모은다는 것은 굉장히 큰 노력인 거죠
01:07:29그것도 아주 정교하게 만시간의 데이터셋들을 좀 더 굉장히 고품질로 만들어서 더 넣어줬던 것들이 경량화가 됐음에도 불구하고 성능이 좋아졌던 것이고 그다음에 정확성도 얘가 이제 액션 단위로 처리가 된게 아니고 디퓨전 폴리시라든 디퓨전 계열에 어 플로우 매칭을 쓰다 보니까 좀 더 정확해진 이제 그런 부분들이 존재한다라는 것입니다
01:07:53그다음에 요걸 이제 조금 더 이렇게 패스트 좀 더 빠르게 하기 위해서 압축을 합니다
01:07:59토큰을 이제 압축을 해서 처리했더니네 배 정도 더 빨라졌더라 하는 부분들이 제로 패스트에 해당됩니다
01:08:11그러면 이제 여기서도 여기에 질세라 [음악] 예 대충 보고 넘어가겠습니다
01:08:18네
01:08:18그래서 이제 쭉 정리를 해 보면 이제 오픈 V 대비 이제 파이의 성능의 요소는 뭐냐면 사전 학습 규모의 차이가 있다라는 것입니다
01:08:31파이가 더 방대한 데이터를 학습한 것이고요
01:08:37그다음에 V의 사전 학습 데이터의 품질 품질도 더 좋아졌어
01:08:37만 시간 정도 규모의 정교한 데이터를 이제 모아 준 거예요
01:08:43그래서 품질뿐만 아니라 추가적인 데이터셋이 더 추가가 된 것이고요
01:08:49그다 액션 표현 방식이 달라진 거죠
01:08:49아까처럼 이제 액션 단위로 처리하는게 아니고 트라토리 단위로 처리하도록
01:08:56그 경량화대 성능 모델 크기는 이제 VNA보다 작지만 그래도 이제 데이터 품질 학습 기법 이제 효율성 대비 성능을 성능 역정되습니다
01:09:07작지만 그래도 정확하고 더 범용성이 높아진 이제 그런 어떤 것들이 이제 그다음에 여기서도 이제 보시면 빨라졌어요
01:09:1350Hz 정도로 아까 이제 오픈 VL는 7 5Hz 정도였어
01:09:21그럼 이제 10배 정도 사실은 이제 트레도 빠르게 된 것이죠
01:09:27이제 다양하게 이제 뭐 시간상 이제 요거는 나중에 한번 자료 오픈될 거니까 보시고요
01:09:32음
01:09:32아까 내용들 그다음에 여기서 이제 특히 특히 이제 이쪽에서 이제 좀 더 강조했던 부분들이 이제 강화 학습을 도입하 아까 RLHF처럼 좀 더 정교한 튜닝을 위해서는 강화 학습을 좀 도입하는 것이 좋다 정도의 어떤 내용들 이런 부분들이 돼 있고 여기서 이제 보시면 빨래 계기가 이것도 엔드투 엔드죠
01:09:51처음에 이제 어 새끼에서부터 갖고 와서 그 롱텀의 어떤 그 타스크를 굉장히 잘 처리하는 이제 그런 습성들을 보여요
01:10:04그래서 제가 보기에는 파이만 제대로 여러분들이 써도 어느 정도 성능은 나오지 않을까? 파이 0.5도 나왔는데 아쉽게도 걔는 오픈이 안 돼 있어요
01:10:17예
01:10:17네
01:10:17잘 열 가지 정도를 제가 정리해 놨으니까 한번 쭉 보시기 바라고요
01:10:24그다음에 이제 휴먼노이드 계열에서는 이제 헬릭스 이제 피규어 AI 이쪽이 이쪽 나오기 시작했어요
01:10:30여기서도 이제 여기서 이제 아까 처음에 나왔던 시스템과 시스템 2 개념으로 여기서부터는 이제 정리가 되기 시작했습니다
01:10:36느린 느린 시스템 2
01:10:36여기서 이제 플래닝하고 뭐 타스 이제 조금 더 세부적으로 하고 나머지 롤레벨에서는 그거를 이제 디퓨전 계열로 해서 아까 플로 매칭을 통해서 여기서부터는 플로 매칭이 장착이 정착이 돼 있어요
01:10:49그냥 대부분 롤레벨은 플로 매칭을 이제 사용한다
01:10:55이제 그 정도의 어떤 형태
01:10:55그렇게 해서 여기서는 어 200Hz 아까 50Hz에서 한 네배 정도 빨라진 형태로 이제 얘가 처리합니다
01:11:05이것도 오픈돼 있지 않아요
01:11:05맨 처음에 얘는 GPT를 썼어요
01:11:11백번으로
01:11:11근데 지금은 이제 나름대로 자기의 어떤 형태 나름대로 그다음에 여기서는 500시간에 이제 멀티로봇 데이터로지도 학습을 했다
01:11:20이제 이런 어떤 특징을 갖고 있습니다
01:11:25자 넘어가도록 하겠습니다.음 예도 한번 나중에 보세요
01:11:30일단은 [음악] 그다음에 이제 엔비디아에서 즉 글론트 엔원이 있고 이제 1.5가 모가 나왔는데 여기서도 마찬가지로 이제 여기서도 여기서 이제 이글 이제 백번이 2B 정도 되는 거죠
01:11:492 정도고 그다음에 어 마찬가지로 이제 시스템 2, 시스템 형태로 이제 해서 요런 어떤 특성들을 갖고 있고요
01:12:00시스템원은 이제 120Hz 정도 이렇게 하고 있습니다
01:12:00그다음에 뭐 아까 COT나 이런 것들 이제 쭉 도입이 되기 시작한 것이 그렇게 하면 그러면 이제 아까 이제 그런 속도라든가 이런 부분들 트레이드오프 한계들 요런 것들을 고려를 해 봐야 되는 부분들이 있습니다
01:12:12자, 것도 넘어가겠습니다
01:12:19음
01:12:19근데 재미나 로보틱스 요것도 보면은 이제 근데 요것도 오픈이 안 돼 있어요
01:12:25실제로 근데 거의 비슷한 컨셉으로 이제 처리가 됐다 정도로 일단은 가음하겠습니다
01:12:36이제 파.5 뭐 사실은 이제 지금 저 그니까 사실 이제 중국 로봇들이 뭐 뭐 아크로바틱도 하고 뭐 하지만 사실 제일 중요한 건 범명성이거든요
01:12:42실제로 이제 범명성과 정확도 왜 그러냐면 여러분들이 뭐 휴머노이드가 제주를 부린들 그 일을 하는데 있어서 크게 의미가 없거든요
01:12:54범명성이 있어야지만이 내가 이제 새로운 환경에 가서도 그냥 자기가 계속 능숙하게 일을 할 수 있도록 해 주는 부분들
01:13:01이제 그럼 근데 여기서도 마찬가지 시스템과 시스템 2로 나눠서 처리합니다
01:13:08여기서도 이제 아까 파이에서 달라진 거는 시스템과 시스템로 나눠진 거다
01:13:08이렇게 해서 한번 레이어가 하나 더 들어간 것이고요
01:13:14그다음에 사전 학습 데이터가 더 많아졌다
01:13:14더 범형성이 강조가 된 거죠
01:13:21두 가지 정도가 이제 더 이제 추가가 됨으로 인해서 굉장히 강력한 성능을 이제 보이기 시작을 하는 것입니다
01:13:26그래서 여기 보시면 이제 이거는 이제 어떤 컨셉을 했냐면 이제 그 이제 청소를 하는 청소 용역하는 형태로 이제 가는 거 범형성이 있다 보니까 얘는 한 100개 정도의 개 열 군데 정도의 이제 그 주방이나이 이쪽을 다 훈련하고 나서 출장을 보내는 거야
01:13:52그래서 누가 이제 코를 하게 되면 이제 로봇을 싣고 갑니다
01:13:52그래서 싣고 가서 거기다 조립해서 놔주면 거기 있는 주인이 마이크로 뭐 해 달라, 뭐 해 달라
01:13:59자기 일을 하면서 이제 처리하는 그런 내용들이 이제 여기에 들어 있는 거죠
01:14:05음
01:14:05자, 이것이 이제 그래서 파이 0.5가 서모가 굉장히 법명성도 뛰어날 뿐더로 어 작업 이제 실질적으로 이제 굉장히 우리 현실 세계에 많이 접근해 있는 이제 이런 부분들이라고 이제 볼 수가 있습니다
01:14:25예
01:14:25자기는 그냥 일을 하는 거예요
01:14:25그러고 나서 이제 나중에 시간 되면은 얘가 이제 걷어가고 또 다른데 가서 또 일하고 뭐 이런 식으로 이제 범행성이 굉장히 뛰어나다
01:14:31사실 여기가이 피지컬 인텔리전트라는 회사가 엄청나게 큰 돈을 투자를 받았죠
01:14:40어마어마한 돈을 투자를 받아서 이제 사실은 굉장히 영 활발하게 어 진행이 되고 있고 어 우리나라도 이런 형태의 어떤 컨셉으로 가야 되지 않을까? 중국은 너무 이렇게 쇼잉 위주로 이렇게 많이 가는 거 같은데 실질적으로는 우리가 이제 이런 부분들로 이제 범명성이 좀 뛰어난 부분들로 이제 가는 것들이 좀 필요하다라고 이제 볼 수가 있습니다
01:15:06그래서 지금 이제 어느 정도 이제 아까 얘기했듯이 세부트닝 이런 부분들만 조금 더 잘하게 되면 그래도 이제 실 이제 적용이 될 수도 있는 성능 단계까지 오지 않았나 이제 그렇게 이제 이제 생각을 해 보고 있어요
01:15:26저희도 이제 사실은 이제 실험실 레벨 실험을 좀 해 봤으면 좋았을 텐데 이런 걸 그냥 해해 보지 못했지만 향후 아마 이제 저희가 이제 새롭게 이제 저희가 회사를 이제 어 할 수 있는 어떤 환경이 좀 될 거 같아서 한 내년도쯤에는 아마 이런 부분들을 한번 직접 테스트해 보고 제가 농업 쪽에 한번 적용을 지금 해 보려고 생각합니다
01:15:47서로 재배한다든가 이런 부분들에 실질적으로 이제 파종하고 그다음에 이제 어 그런 부분들 그다음에 이제 그거를 이제 수확하고 이런 부분들을 조금 더 잘 해 볼 수 있는 그런 부분들로 가야 되지 않을까 이렇게 생각을 하고 있어요
01:16:03자 일단 넘어가서 그다음에 이제 스몰 VLA 얘는 엄청 격려가 돼어
01:16:100.3B예요
01:16:170.4B 0점 어 0.4 0.45B 4이 근데 굉장히 좋다라고 얘기하고 있는데 제가 보기엔 아직 이게 다른 데고 비교 테스트가 안 돼 갖고 자기들만의 리그인 것 같은 생각이 들어요
01:16:29여기서 이제 르로봇을 만든 데서 허깅 페이스에서 지금 이제 이런 부분들을 공개했고 여기선 경량화의 어떤 조금 더 증점적으로 이렇게 그래서 얘는 지금 지표가 없어도 돌아가요
01:16:43예
01:16:43그렇지만 조금 이제 여기서도 이제 범명성 뭐 이제 아까 경 이제 속도도 좀 어느 정도 이제 개선이 된 거고요
01:16:50이제 그런 어떤 관점에서 봤을 때는 조금 이제 검증이 좀 돼야 될 거 같은 생각은 있습니다
01:16:58논문도 나와 있지만 아직 뭐 이렇게 비교 비교해서 테스트해 본다든가 이런 부분들이 없어서 그냥요 정도만 소개를 하고 하면 될 거 같고요
01:17:04마찬가지로 이제 저 돈 이제 만약에 비용이 적게 이제 실로 일반적인 어떤 아까 이제 저가 모델에서는 이런 것들을 통해서 한번 테스트를 해 보는 것도 이제 바람직하다라고 볼 수가 있습니다
01:17:22자, 일단은 그 VL의 이제 속재라고 보시면 이제 계속 이제 경량화 계속 돼야 되겠죠
01:17:27우리가 이제 보시면 인베 시스템에 이제 집어넣어야 되는 부분들이 있다 보니까 이제 어쨌든 지금은 어 인베 시스템 못 들어가고 실제 이제 서버 클라이언트 형태로 이제 계속 이제 외부에서 그것들을 이제 쭉 해 주는데 어 저희가 이제 콜컴이나 이런 쪽은 MPU가 있다 보니까 이런 쪽을 이제 조금 더 경량화 작업들을 하다 보면은 조금 더 이렇게 그런 쪽을 타게팅해서 하다 보면은 그 사이즈 안에 들어갈 수 있게끔 한다든가 그런 노력들을 좀 해 생각도 있고요
01:17:53그다음에 이제 일반화도 이제 많이 이제 진척이 된 상태입니다
01:17:59그래서가 일반화 프 이거는 이제 프리트레이닝 사전 학습을 얼마나 많이 했느냐 그냥 아무말 잔치 그 실제 로보트하고 관계 없어도 굉장히 다양한 어떤 테스트를 하게 되면 거기서 이제 일반화가 생기고요
01:18:12그다음에 얘가 로봇이 실수했을 때 내가 만약에 뭔가를 집어야 됐는데 못 짚고 다시 리트라이 할 때도 일반화가 되게 중요해
01:18:24일반화가 잘 돼 있으면 얘가 실질적으로 잡지 잡아야 되 놓쳤을 때 다시 한번 리트웨어 한다든가 이런 부분들을 되게 잘하게 됩니다
01:18:32그래서 일반화도 굉장히 중요한 상태고요
01:18:32그다음로로 레벨의 정확성 현재 지금 거의 플로 매칭으로 지금 기결이 됐는데 요것들도 이제 계속 이제 조금 더 성능 향상을 하기 위해서 노력하고 있습니다
01:18:43근데 당장은 이제 플로 매칭이 이제 어느 정도 이제 안정화돼 있는 거 같고요
01:18:50그다음에 이제 아까 이제 사람과 같이 있거나 이럴 때는 이제 안전성과 신뢰성 이런 부분들도 이제 처 이제 봐야 될 거고 데이터 품질 확보 아까 있듯이 이제 데이터의 품질도 굉장히 중요합니다
01:19:03그다음에 이제 이거를 굉장히 많은 데이터량이 있느냐 없느냐에 따라서 성능이 달라질 수가 있기 때문에 이런 데이터 품질 확보나 이런 것들이 종의할 수가 있습니다
01:19:17응용 분야는 이제 실질적으로 이제 창고 물류 뭐 자동화 뭐 이제 아까 보면은 이제 청소 로봇 산업력 조립 로봇 의료 쪽 농업 건설 현장 뭐 이런 부분들에 이제 사실은 이제 매우 근접해 있지 않을까 아 1, 2년 사이면은 그래도 실질적으로 이제 VLA가 적용이 될 수 있는 그런 단계까지 가지 않을까 생각을 하고 있습니다
01:19:37왜 그러냐면 이게 GPT 발전 속도하고 거의 비슷하거든요
01:19:44LNM의 발전 속도하고 사실은 얘는 똑같은 맥락을 갖고 있어요
01:19:52LNM 자체가 굉장히 급속도로 발전하듯이 얘도 지금 불가 사실은 오픈된지 1년 사이에 굉장히 많은 실질적으로 많은 변화가 있었던 것이고 현실화가 되고 로봇의 파라다임이 완전히 바뀌어 있는 상태인 거죠
01:20:07그만큼 사실은 그다음에 앞으로 1년이면 엄청난 변화가 더 있을 수 있을 거로 생각을 하고 있어요
01:20:15자, 이상으로 발표를 마치도록 하겠습니다
01:20:20자, 감사합니다
01:20:20아, 잘 들으셨어요
01:20:20음, 지금 이제 여기 예, 우리 랩장님이 간단하게 Q&A를 좀 받을까 하는데요
01:20:29어, 일단은 순서가 Q&A를 받고 여기 만족도 조사하시나요? 예
01:20:42만족도 조사를 하고 신을 갖고 네트워크 파티가 있어요
01:20:42그 세 개로 나눠 갖고 관심 분야를 질문할 수 있는 시간이 있으니까 뭐 끝까지 남아 주시면 좋을 것 같고요
01:20:48일단은 Q&의 시간이니까 궁금하신 분 있으면 손을 들어 주시고 그다음에 이제 소속이라든가 간단한 소개한 다음에 질문을 해 주셨으면 좋겠습니다
01:21:01네
01:21:01부탁드리겠습니다
01:21:01손 들어 주시면 마이크 드릴게요
01:21:10네
01:21:10안녕하세요
01:21:10그 강의 잘 들었습니다
01:21:10저는 유재홍이라고 하고요
01:21:10제가 이제 이해한 바로는 VLA에서도 역시 뭐 모방학습과 같이 마찬가지로 학습 데이터셋이 중요한 걸로 제가 이해를 했는데 이제 데이터셋을 만들 때 그 좋은 데이터셋이라는 건 도대체 어떤 기준으로 현재 판단을 하고 있는지 궁금합니다
01:21:26예를 들어서 실패한 데이터셋도 일반화를 위해서 좋은 데이터셋이 되는 건지 아니면은 오직 이제 성공한 데이터 특정 테스크를 성공한 데이터만 이제 좋은 데이터인지 이제 분류하는 건지 궁금합니다
01:21:37그리고 만약에 이제 데이터셋에 오염된 데이터셋이 데이터가 들어갈 경우에는 이제 그게 성능에 유의미한 차이를 주는지도 이제 궁금합니다
01:21:50아, 네
01:21:50그 지금 아까 이제 프리 트레인 할 때는 좋은 데이터 나쁜 데이터가 이렇게 아주 그냥 파인튜닝보다는 좀 덜하지만 파인튜닝 할 때는 좀 굉장히 어떤 뭔가 규칙적이고 그다음 시간도 시간이나 그다음에 어떤 패스라든가 이런 것들이 좀 더 규칙적으로 이렇게 되어져 있고 그다음에 로봇이 잘 잡기 위해 하기 위해서 막 직선으로 가서 막 우리 컵을 잡는 거보다는 구간별로 를 끊어서 이렇게 뭘 해 본다든가 뭐 그런 식으로 이제 로봇이 이해하기 쉽게 할 수 있는 그런 형태로 데이터셋을 만드는 것이 조금 더 이렇게 품질이 좋은 데이터라고 볼 수가 있을 거로 생각합니다
01:22:29그래서 그냥 무조건 그냥 사람처럼 막 가는게 아니고 조금 더 이렇게 타스크들을 나눴을 때 생각해 가면서 조금 더음 그런 부분들 고려하면 좋을 것 같고 그다음 시간이 이제 막 길었다 짧아졌다면은 그것도 좀 요인이 되는 거 같아요
01:22:43그래서 일정한 시간 내에 조금 더 이렇게 잘 세부적인 세부적으로 나눠서 처리하는 형태가 어 좋은 품질의 데이터라고 생각을 하고 있습니다
01:22:55네
01:22:55답변 감사합니다
01:23:01네
01:23:06뒤에 있는 분 먼저 드릴게요네
01:23:12아, 네
01:23:12안녕하세요
01:23:12저는 D렙의 전민규라고 합니다
01:23:12네
01:23:12강의 잘 제가 그 로봇 쪽을 사실 잘 모르고 L, LM 쪽만 알아서 그런데 이게 로봇의 쪽, 로봇의 행동 같은 거를 좀 일반화를 해야 되는 것 중에 하나 또 목표였잖아요
01:23:27그렇게 발전되기도 했고
01:23:27근데 이제 로봇들 별로 사실 할 수 있는 그 액션 같은게 좀 다를 텐데 혹시 막에 표준화되거나 그런게 좀 있을까요? 근데 그 일반화라는 거는 관절로 이렇게 보는게 아니고 엔드 이펙트 끝점으로 이렇게 보거든요
01:23:46그러면 이제 그거를 이제 인버스키네마틱을 하게 되면 관절값들이 쭉 나와요
01:23:53그래서 보통 보면은 이제 그런 식으로 이제 엔드 에펙트가 이제 뭐냐에를 이제 실질적으로 보고 그니까 초창기에는 이제 모바일 알로나 이런 거 간절로 이렇게 하다 보니까 간절의 길이가 다르고 그다음 DH 파라미터 다르다 보니까 그것이 일반화가 덜 됐는데 지금은 이제 거의 엔드 이펙트 형태로 하게 되면은 나머지는 이제 그 인버스 키네마틱으로 정리하게 되면은 일반화가 됩니다
01:24:17그래서 그런 부분들로 보통은 많이 진행을 하고 있어요
01:24:17예
01:24:22네
01:24:22음
01:24:22아, 그러니까 약간 음 뭐 네
01:24:22수학적 같은 그런 걸로 좀 관절 같돼 있으면은 네
01:24:31그 로봇이 체계가 좀 다르게 되어 있어도 적용이 된다라는 거 같고
01:24:37네
01:24:37네
01:24:37그렇죠
01:24:37이제 끝점 보통 이제네마틱이라고 해서 예
01:24:37끝이 있으면 여섯 그러면 얘가 이제 간절의 길이 그다음에 각도 그다음에 형태 이런 것들이 다 계산이 돼서 끝점이 나오는 거거든요
01:24:50그럼 반대로 얘가 이제 해당되는 끝점을 통해서 이제 그거를 역으로 계산하게 되면은 각각의 관절들이 쭉 계산이 돼서 나와요
01:24:57그럼 그 끝을 어떻게 할 것이냐만 고려하면 되는 거야
01:25:03그게 이제 인버스 키네마틱이라는 개념입니다
01:25:08네
01:25:08네
01:25:08감사합니다
01:25:08네네
01:25:08예
01:25:08음
01:25:14어, 질문 또 없으십니까? 예
01:25:14예
01:25:21아
01:25:21예
01:25:21안녕하세요
01:25:21저는 예
01:25:21번넥트에서 온 하태진이라고 하는데요
01:25:21그 제가 이제 그 엔지니어링 쪽은 제가 정확히 잘 모르겠지만 그냥 그 궁금한 점이 하나 있어 가지고
01:25:28네
01:25:35그 LMM을 써 보면은 할루시네이션이 있잖아요
01:25:35근데 그거를 이제 로봇 쪽으로 도입해 보면은 생각해 보면은 어 로봇도 이제 실수를 할 수 있을 것 같아요
01:25:40그러면은 그게 이제 뭐 가정일이나 이런 것들은 실수해도 뭐 크게 문제는 없다고 좀 생각이 될 수 있는데 어떤 이제 산업용이라든가 미션 크리티컬한 그런 업무를 할 때 실수하게 되면 큰 사고가 날 수 있잖아요
01:25:58네할루시네이션 같은 현상이 있으면 안 되는데 그런 것들을 방지하려면은 어떻게 하면 좋을지 그리고 어 그 클로즈 루프 방식으로 이제 뭐 할 수도 있지 않을까라는 생각도 있긴 한데 그렇게 하는 그 그러 그니까 여러 방식 그 어 어떤 방식이 그런 이제 시술를 줄일 수 있을지 그런게 좀 궁금합니다
01:26:17그러니까 이제 일반화가 얼마나 됐느냐에 따라 달라질 수 있어
01:26:23아까도 보셨듯이 일반화가 잘 됐으면 뭔가 이렇게 제대로 못 집어도 다시 리트라이를 되게 잘하게 되거든요
01:26:31만약에 이제 할로시네이션이 있어서 얘가 잘못되어 있다 할지라도 내가 이제 해당되는 것을 다시 이제 리트라이 하면서 처리를 하도록 하하는 건데 그거는 일반화의 어떤 컨셉 프리트레이닝을 굉장히 다양한 데이터들을 모아서 처리하게끔 한다든가 그다음에 이제 화인 튜닝을 해야 돼요
01:26:50그래서 이제 아까 RLHF 형태 그래서 이제 로봇이 계속 이제 뭘 했는데 이제 여러 개의 액션들이 이제 동작들이 있으면 그러면 이제 강화 학습을 통해서 얘가 이제 이것이 더 좋아이 더 좋아을 계속 더 정밀하게 해 준다든가 뭐 그런 식으로 처리할 수 있을 것 같고요
01:27:16그다음에 제가 보기엔 로봇의 어떤 액션들은 사람의 어떤 언어보다는 굉장히 바운더리가 크지 않다고 봐요
01:27:22뭐냐면 지금 이제 일반 언어들은 엄청나게 많은 어떤데 것들이 있지만 로봇이 사실 할 수 있는 행위들은 그렇게 뭐 아까 봤듯이 527개 혹은 뭐 1천000개이 정도면은 언어로 이렇게 했을 때보다는 굉장히 크 많지 않은 부분들이다 보니까 조금 더 그런 부분에서 이제 할로시네이션이 조금 더 덜 할 수 있는 왜 그러냐면 어떤 지부라고 했을 때 얘가 말을 이렇게 잘못 알아듣거나 이럴 경우는 그렇게 크지 않거든요
01:27:56밸루시네션이라는 것은 내가 학습하지 않은 것들이 데이터가 들어왔을 때 그 부족한 데이터량을 가이 있다 보니까 할루시네이션이 된다라고 보 뭐 세정대항이 뭐 아이패드를 던졌네 하면은 그거는 이제 대량이 부족하니까 이제 그렇게 나온다라는 것이고 실질적으로 우리가 로봇 같은 경우에는 내가 원하는 걸 아까 파인튜닝 할 때 계속 더 이렇게 거기에 집중적으로 하다 보면은 그런 부분들은 별로 이렇게 발생이 덜하 하지 않을까 그렇게 생각을 하고 있습니다
01:28:27아, 네
01:28:27음
01:28:33네
01:28:33저 좋은 강년 잘 들었습니다
01:28:33저는 LG 전자에서 온 최윤성이라고 하는데요
01:28:33그러니까 그 강연 중에 중국 기술은 좀 쇼잉이라고 말씀을 하셨는데 주로 이제 미국 또 실리콘밸리 쪽 사례를 많이 주셨는데 실제 중국은 요즘 되게 이제 뭐 전시라든지 되게 실제적으로 많이 보이고 있어 가지고 왜 왜 그런 생각 하시는지 혹은 미국과 중국의 이제 기술의 방향성이나 이런 차이가 있는지 아니면 단지 속도 차이가 좀 있는 건지 궁금해서 아예 예 제가 잘못 얘기 한 거 중국도 되게 엄청나게 사실은 앞서 있는 건 맞는데 거기는 그런 법명성보다는 보여주기를 많이 하고 있고 그다음에 마라톤이나 뭐 이런 달리기도 사실은 그게 VLA를 통해서 했던 한 거라고 봐야 되는 건지 아니면 뒤에서 조정을 했다고 봐야 되는 건지 모션도 보면은 그거는 아주 그냥 범명적인 것들이 아니고 특수한 걸 계속 집중적으로 훈련을 시킨 거잖아요
01:29:25이제 그럼 거기에는 이제 중국에는 뭐 이렇게 학습 이제 학습형 공장도 따로 있고 그렇다고 하더라고요
01:29:38그래서 거기서는 보면은 그런 어쨌든 중국은 인원도 많고 그런 부분들이 잘 갖춰져 있다 보니까 특정한 액션들을 계속 집중적으로 이렇게 하게 되면은 좋아질 수 있다라고 보고 있는데 근데 과연 그게 일상생활에서 그런 범명성하고 매칭이 잘 될까 하는 부분들이 그니까 범행성이라는 것은 뭐 이렇게 그런 어떤 특수한 기능을 잘하는게 아니고 내가 알아서 이제 해당되는 것들을 이제 아 해 보지 않은 것들도 도 해볼 수 있게끔 그런 부분들이 범명성인데 우리가 사실은 필요한 거는 로봇을 활용할 때는 그게 더 조금 더 이렇게 현실적이지 않을까 이제 그렇게 생각을 하고 있는 부분들입니다
01:30:19예
01:30:19네
01:30:19예
01:30:31예
01:30:31잘 들었습니다
01:30:31전 현대 오토벌에서 최웅용이라고 합니다
01:30:31그 향후에 이제 로봇에도 실제 적용할 계획을 가지고 계신다고 하셨는데 그때는 어떤 모델을 한번 사용하실 계획을 가지고 계실지? 저는 파이파0 예, 파이가 경량화도 됐고 그다음에 거기가 사전 학습이 잘 돼 있어요
01:30:50저희가 지금 사실은 어 로봇 레퍼런스 파운데이션 모델을 사실 만들기는 쉽지 않은 거 같아요
01:30:56파운데이션 모델이라는 거는 어떤 단계에서인지 모르겠까지도 할 수도 있는 거고 아니면 VLA 단계에서 파인 파운데이션 모델이 나올 수도 있는데 그걸 하려면은 아까 데이터셋이나 그 방대한는 것들을 몇몇 인원이 그걸 하기에는 쉽지 않기 때문에 저희는 그냥 파인튜닝을 해서 하는 것들을 이제 고려하고 있고 있는데 그러면 이제 파이제가 아까도 보면은 조금 도 이렇게 좀 신경을 많이 쓴 예, 그런 모델인 거 같습니다
01:31:32경량화도 많이 돼 있고
01:31:32예
01:31:32예
01:31:32그리고 추가 질문이 하나 더 있는데 아까 뭐 강의에서도 언급을 해 주신 것처럼 그 가상 환경 있잖아요
01:31:39온데버스나 그루트 같은 그런 것들도 향후에 뭐 가상 환경을 이용해서 학습할 계획도 가지고 계신 건가요? 아, 네
01:31:46일단은 그르트에서는 어떻게 했냐면 이제 실질적으로 가사한경으로 돼 있으면 액션들이 없으니까 그 액션들을 실질적으로 시뮬레이션까지 해서 그것까지 다 통합해서 처리하고 있는 부분들도 있고요
01:32:00그다음에 가상 환경이라도 그것이 범용성에 굉장히 도움이 되거든요
01:32:07가상 환경 자체가
01:32:07그래서 뭐 실질적으로 이제 저는 이제가 이제 그런 범형성은 아무말 잔치라고 그러니까 내가 막 사실은 이제 내가 원하는 것만 정확하게 하는 거 외에 뭐 이렇게 잡다한 것들을 막 이제 얘기하면서 그것이 이제 범명성이 생긴다고 보고 있는데 마찬가지로 이제 그 가상 환경도 이제 법명성에 이제 어 포함되고 있고 그다음에 그 월드 뭐였죠? 월드 모델인가요? 월월드 모델은 지금 보면은 비디오 쪽 3D 쪽을 지금 계속 사전 학습을 시키는 거잖아요
01:32:42그러니까 이미지는 지금 패치 단위로 해서 계속 자기가 사전 학습을 해서 이미지를 쭉 훈련을 시키는 거고 그다음에 3D 이제 이미지는 비디오는 프레임을 계속 사전 학습 이제에 자기지도 학습으로 하는 거라고 보고 있어요
01:33:02그래서 지금 비디오 쪽은 계속 그러니까 그러면 이제는 비디오를 잘 이렇게 훈련받은 그렇게 해서 얘가 버튼 있으면 얘가 이제 그 해당되는 버튼으로 가서 그 월드 이제 3D 모델을 잘 하는데 마찬가지로 그런 부분들을 엔비디아는 되게 잘하고 있어서 그런게 실질적으로 이제 VLA 쪽에 들어가기면 좋을 것 같고요
01:33:27그다음에 지금은 이제 자세만 현재 지금 추가가 됐잖아요
01:33:27근데 아무 지금 이제 뭐 센스 센싱한 것들도 이제 실질적으로 이제 의미 벡터로 만들 만든다든가 다양한 어떤 그 감각적인 것들이 VLA 쪽에 더 이렇게 추가가 될 수 있을 거로 생각이 되고 있어요
01:33:45면은 실질적인 비디오나 지금 텍스트 자세뿐만 아니라 다른 감각들도 인베딩이 되면은 실질적으로 봤을 때는 그 감각을 통해서 조금 더 잘 이렇게 훈련이 될 수 있는 부분들도 있다라고 생각을 하고 있어요
01:34:03예
01:34:03예
01:34:03감사합니다
01:34:03네
01:34:03예
01:34:03마지막 질문 하나 받고 이제 네
01:34:12안녕하세요
01:34:12어, 번넥트의 전승우라고 합니다
01:34:12그 지금 강화 학습을 통해서 그 어, 시뮬레이션 안에서 학습시키는 거를 주로 하고 있는데 어, 이게 제가 알기로는 심투 리얼 개비 강화 학습을 통해서 했을 때 좀 심하게 나는 거 같더라고요
01:34:29모델을 넣었을 때 어 시뮬레이션 잘 돌아갔지만 이제 물리 환경이 완벽히 똑같이 않기 때문에 리얼 환경에서 그런 이슈들이 좀 있는 걸로 알고 있는데 이게 VLA로 학습을 시뮬레이션상에서 돌리더라도 이게 실제 로봇에 적용했을 때는 저희가 학습시켰던 것처럼 동일하게 동작하지 않을 가능성이 있을 것 같은데 이런 거를 어떤 식으로 좀 파인 튜닝을 할 수 있을지가 궁금합니다
01:35:00그 저 그거는 보조 수단으로 전 생각하고 있었지 그것이 메인으로 생각하진 않았거든요
01:35:00그래서 아직은 그거에 대한 저는 해결 아직은 어떻게 해야 될지는 감의도 조금은 그러냐면 물리적인 컨셉이나 그런 부분들도 있는데 그 엔비디아에서 그런 부분들을 연구를 많이 하고 있는데 저도 그 그루트 엔이나 이런 부분들이 또 그 어떤 데이터셋을 쓰고 있는지 이런 부분들을 조금 더 이제 아직 더 보고 있어요
01:35:25아직 거기까지는 조금 더 이렇게 제가 못 미쳐 갖고 그 부분들은 조금 이제 미지로 저는 생각하고 있습니다
01:35:30한 분 더 이렇게 아까 질문 예 어 어음 어네 안녕하세요
01:35:51저는이 건물 7층에서 AI 로봇 연구 개발하고 있는 파이브레인의 송준호라고 합니다
01:35:58그 파운데이션 모델을 파인튜닝 시킬 때 제가 궁금한 건 그 유튜브에 영상이 되게 많잖아요
01:36:06수많은 상들 중에 사람이 1인칭 시점으로 찍은 그 양팔이 보 나오는 그런 유튜브 영상들을 다 모아서 데이터셋으로 모아서 내가 원하는 파운데이션 모델을 그 파인 파 파 파인튜닝을 시킬 수 어 시키면 어떨까라는 순수한 좀 궁금증이 있었는데 그게 좀 효율이 좋을까요? 그건 이제 프리트레이닝이라고 봐야 될 거 같고요
01:36:33바인트닝은 실제 내가 원하는 목적을 위한 어떤 학습이거든요
01:36:40뭐냐면 내가 만약에 어떤 아까 이불 계기나 이런 것들이 되면은 그 이불 계기라는게 똑같은 형태로 돼 있지 않을 거 아니 아 아닙니까? 이제 그러다 보니까 그다음에 거기는 물리가 없어요
01:36:53그러니까 결국 데이터셋이 다 완벽하게 되려면 얘가 이제 아까 자세 정보라든가 이런게 다 돼야 되는데 유튜브에 있는 정보들은 사실은 그게 완벽한 정보가 아니다 보니까 학습의 학습의 대상이 될 수가 없습니다
01:37:11그래서 그런 부분들은 실질적으로 이제 데이터셋 만들 때 우리가 이제 리더 팔로우 하게 되면은 자세가 다 이렇게 다 맵임마다 다 지정이 되거든요
01:37:18근데 유튜브에서 그런 부분들이 없다 보니까 학습을 하기는 조금 쉽지 않은 구조일 것 같아요
01:37:24예
01:37:29[음악]


 VLA 모델은 언어 모델(LNM)에서 시작하여 시각-언어 모델(VLM)을 거쳐 발전했으며, 로봇 지능의 미래는 데이터셋의 품질과 양, 그리고 모델의 경량화에 달려있다.