00:01Everyone's talking about RAG
00:03If you feel left out, this is the only video you need to watch to catch up
00:04In this video, we'll learn RAG in a super simplified manner with visualizations that will make it easy for anyone to understand
00:12No background knowledge in AI or AI models or coding or programming required
00:17We'll start with the simplest explanation of RAG there is
00:18Then we'll look into when to and when not to RAG
00:25We'll then look into what is RAG
00:32We'll then understand some of the prerequisites, such as vector search versus semantic search, embedding models, vector DB, chunking using a simple use case, and finally bring all of that together into RAG architecture
00:38We'll then look into caching, monitoring, and error handling techniques, and close with exploring a brief setup of deploying RAG in production
00:41But that's not all
00:45This is not just a theory course
00:48We have hands-on labs after each lecture that will help you practice what you learned
00:54Our labs open up instantly right in the browser, so there is no need to spend time setting up an environment
00:58These labs are staged with challenges that will help you think and learn by doing, and it comes absolutely free with this course
01:06I'll let you know how to go about the labs when we hit our first lab session
01:10For now, let's start with the first topic
01:12Let's start with the simplest explanation of RAG
01:13Say you were to ask ChatGPT what's the reimbursement policy for home office setup
01:20You already know when you ask this question that ChatGPT is going to give an incorrect answer because it doesn't have access to our policy document that's private to our company
01:31So an LLM like GPT would hallucinate and provide an incorrect or generic answer that's common to most companies
01:37The problem here is that it doesn't have the necessary context of what you're asking about
01:44So what do you do? You look up your internal policy document and get the section of the policy that describes home office setup by yourself
01:52Then you add that to your prompt and tell ChatGPT to refer to this policy
01:57Now, with this additional information, ChatGPT is able to generate more accurate responses, and that is the simplest
02:08explanation of RAG, that stands for Retrieval Augmented Generation
02:15The part where you look up your internal policy documents and retrieve the relevant information is known as retrieval
02:22The part where you improve or augment your prompt with the retrieved information is known as augmenting
02:29And the part where the LLM generates a response based on the augmented prompt is known as generation
02:36And that is something you've done unknowingly many times
02:38Now, of course, that is a very simplified explanation of RAG
02:43And when we talk about RAG systems, that is not what we typically refer to
02:47So let's see what that is next
02:51Now, you don't want your users to have to locate and retrieve relevant information by themselves
02:55Instead, you want your users to simply ask the question, "What's the reimbursement policy of home office setup?" And our system, that's based on RAG, should be able to do the lookup and retrieval of relevant information, improve or augment the user's prompt, and get an LLM to generate the right response
03:16Now, how exactly do we retrieve relevant information? How do we augment? And how do we generate? And that's what we're going to discuss throughout the rest of this video
03:24Now, one of the common mistakes people make is to consider RAG as the solution for everything
03:31RAG is not the solution to all problems
03:34At the end of the day, we're all trying to get AI to generate better responses, and there are different ways to do that
03:40We Can prompt better
03:41That's called prompt engineering
03:42We can fine-tune models
03:44And then there's RAG
03:46When to use what? Let's take a simple use case to understand these better
03:49So, back to our use case
03:51We've started to notice a lot of people copy-pasting company policies into ChatGPT to get answers
03:58So we decided to build an internal chatbot that can answer people's questions
04:02We call it the Policy Copilot
04:04It is a system that users can simply ask a question, such as, "What's the reimbursement policy?" and our chatbot system should be able to locate the necessary information from the internal policy documents and then generate accurate responses and send that back to the user
04:19Now, we also want to add some restrictions and limitations
04:23We don't want the chatbot to answer everything
04:26Some questions should be off-limits, like performance review appeals or salary discussions
04:33And when those topics come up, we want to direct users to HR directly, instead of giving them answers in the chat
04:37We also want our chatbot to have a specific voice and style
04:42So, our CEO has this warm Scottish accent and a particular way of speaking that makes people feel a certain way
04:50We want our policy co-pilot to sound just like that, authoritative and distinctly Scottish
04:55So, when the users ask, "What's the reimbursement policy for home office setup?" it responds
05:02When the users ask, "How many sick days do I get per year?" it says
05:08When the user asks, "Can I work from home?" permanently? It says, and when the users ask, "When are performance reviews conducted?" it responds
05:18As you can see, it's not just the Scottish accent
05:20There's this, what should I say, refreshing candor that tells it like it is
05:24Let's look at how to solve each of these areas
05:26The restrictions and security requires us to define how the chatbot responds, what it must reveal, and what it must not
05:33So, these are strict instructions provided to the LLM to control its behavior based on the user's request, such as never to reveal personal employee information or confidential details
05:44If someone asks about sensitive topics, politely redirect them to HR
05:49Prompt engineering best practices are a good solution to this
05:51Think of it as the rule
05:53book that keeps our chatbot safe and professional
05:56Next, we look at how to solve the problem of voice, style, and language
06:00Now, we know if we asked ChatGPT to simply respond to me in a Scottish accent, it would
06:06But the accent, as we saw earlier, is not simply what we are going after here
06:10We wanted to speak like our Scottish CEO, use words he usually uses, the tone, the language
06:17So, we take all of his past speeches he's given, emails written by him, blog posts, videos created, and fine-tune a new model that can respond in the same language and tone
06:26A good solution for this is fine-tuning
06:31Fine-tuning is the process where you provide a model hundreds of sample questions and sample answers, and have it respond to you in that
06:38all the time
06:41Now, you might be wondering, why can't fine-tuning solve this information problem? Why can't we train a model with all of the questions a user might ask and answers it can generate? The problems are, the policies can change constantly, and when they do, you need to retrain the model every time, and trainings are not easy
06:56They're expensive and slow
06:58Retraining takes time and computational resources
07:00Users can't verify where the answers came from, so there's no citations possible
07:06The larger the training data, the lower the accuracy
07:08And then there's knowledge cutoff
07:10The model only knows what was in the training data
07:12Fine-tuning is great for stable, unchanging patterns like communication
07:16style, but terrible for dynamic factual information
07:18And finally, the best solution to get the most accurate responses is RAG
07:23RAG works because it retrieves information dynamically at query time, not at training time, because the whole point of RAG is retrieving the most relevant information for the user's query in real time
07:36Next, we'll look at RAG in more detail
07:39Let's now look at what RAG is in the first place
07:42So far, we've decided that we're going to build our policy copilot system where employees can ask questions and it retrieves the relevant information, augments prompts, and generates a response
07:54We'll now see how each of these work
07:56Let's look at retrieval first
07:58Retrieval is a process of retrieving relevant information
08:00But how do you do that? There may be hundreds of policy documents
08:04How do you find which one is the right one that has context related to the user's question? And what do you search for within these files? First, we identify a few keywords from the user's question
08:15In this case, we've identified reimbursement and home office to be the relevant keywords
08:19One of the simplest ways is to use a GREP command to search for specific terms in these files, such as reimbursement or home office, and hope that one of these files will have these terms
08:32Alternatively, if these files were stored in a database, you could run a query against it like this
08:35Now, these would only return content that exactly matches the keywords we are looking for, and the chances of getting accurate information every time is low
08:44This approach of searching the documents with the exact words is known as keyword search, and it is a very popular technique that's used by many of the search platforms
08:55To explain it simply, this approach goes through all the documents, identifies keywords, and ranks them based on their frequency
09:02In this case, it counts the occurrences of reimbursement in all documents and records them
09:09So, we have three occurrences in the first document, none in the middle two, but another three in the third one
09:14It then does the same for home office, and we see that it's only present in the home office setup document
09:20Combining these two, columns is now able to identify the document that has the maximum occurrences of these two keywords and thus able to rightly select the document that has these keywords
09:32Now, that was a super simplified explanation
09:33Keyword search is a science in itself and has a lot of complex calculations that go into it, and there are multiple proven approaches available
09:42Two of the most popular techniques used are known as TF and BM25
09:44We won't go into the specifics of how these work; we'll just see how to work with them
09:52Let's see each of these in action
09:53First, we import the TF vectorizer from the scikit-learn open-source Python library
09:58Think of the scikit library as a toolbox with pre-built algorithms that you can use without having to write them from scratch
10:04We then define three sample documents
10:06The documents are simple sentences for now
10:08You could read the contents of a file in
10:10We then create the TF ID of analyzer and we'll call that analyzer
10:14The word scores can then be calculated by running the fit transform method
10:19We then print the results on screen
10:21The word scores show a bi-dimensional array with the importance of each word in each sentence
10:27The word "office" appears in all sentences, so they get a score of 0.4
10:32The first sentence identifies words "equipment" and "policy" and gives them a score of 0.7 and 0.5
10:36The second sentence identifies the words "furniture" and "guidelines", and the third identifies the words "travel" and "policy"
10:43Now that the Vectors are created, we run a query
10:47We use the analyzer to transform to query the word furniture
10:49What it does is it returns an array that returns a score that compares the query word furniture to each document
10:56Now let's see the same with the BM25 techniques
11:01We use the rank BM25 library, which is a popular library that implements a BM25 algorithm
11:06We then create what is known as the BM25 index and then get the word scores
11:11In this case, we can see some differences
11:13The word office gets a score of zero because the BM25 algorithm is a bit more strict in assigning scores, and because this word is present in all documents, it doesn't see it to be very relevant
11:24It then continues to assign a score for the most important and unique
11:28words in sentences like equipment in the first sentence, furniture and guidelines in the second, and travel in the third
11:33And as before, we run a query, but this time using the get scores method and print the array
11:40We can see it's again identified the second document to be the relevant document here
11:44The right way, well, it's time to gain some hands-on practice on what we just learned
11:51Follow the link in the description below to gain free access to the labs associated with this course
11:54Create a free account and click on enroll to start the labs
11:58On the left side of the screen, you will see the list of labs
12:03Only start the lab when I ask you to
12:05We'll do only one lab at a time
12:06Let's start with the first lab
12:08Click on start to Launch the lab
12:10Give it a few seconds to load
12:12Once loaded, familiarize yourself with the lab environment
12:14On the left-hand side, you have a questions portal that gives you the task to do
12:18On the right-hand side, you have a VS Code editor and terminal to the system
12:25Remember that this lab gives you access to a real Linux system
12:27Click on okay to proceed to the first task
12:30The first task requires you to explore the document collection
12:35Open the TechCorp documents in the VS Code editor
12:37On the right, we see there is a TechCorp docs folder
12:42Expand it to reveal the subfolders
12:43The ask is to count how many documents are in the employee handbook
12:48This is what I call a warm-up question that will help you explore and familiarize
12:50yourself with the lab
12:52The real tasks are coming up
12:54In this case, it's three, so I select three as the answer, then proceed to the next task
13:01This is about performing a basic GP search
13:03As we discussed in the lecture, we'll run a GP command to search for anything related to holiday in the folder and store the results in a file named extracted content
13:11To open the terminal, click anywhere in the panel below and select terminal
13:15This creates a new file with the results
13:18Click check to check your work and continue to the next task
13:22The next task is to set up a Python virtual environment and install dependencies
13:27I'll let you do that yourself
13:29We'll move to the next task now
13:31Here we explore the TF script
13:33Here we first import the TF vectorizer from the scikit-learn library
13:38We then transform the dogs
13:40Then we compare using cosine similarities, or cosine is one approach of comparing two vectors to identify similarities
13:47And then we finally print the results
13:49We now execute the script and then we view the results
13:53And for now, we'll just click check to proceed to the next step
13:55We then move to the next step
13:58Here, the question is to analyze the score printed and identify the score of the top results
14:03So the ask is to search for pet policy docs and identify the score for the top result
14:10Here, we see the top result is rightly identified as the pet policy.md file with a score of 0.4676, whereas the other files have a score less than 0.1
14:21So the answer to this question is 0.4676
14:27The next task is to review and execute the BM25 script
14:29Open the BM25 search.py file and inspect it
14:33You'll see that we import the Rank BM25 uh package
14:36We then create an index and then for each query, call the BM25.get_scores method, and from the results, we get the top three results
14:46And we go through each result and print that
14:48Finally, there is a hybrid approach that combines TF and BM25 techniques using a weighted approach
14:56I'll let you explore that by yourself
14:58Let's get back to the next topic
15:00We just looked at vector search
15:03Let's now understand semantic search
15:05Now, one of the challenges with keyword search is that if the exact keyword isn't there, the search fails
15:09For example, instead of reimbursement
15:11If we say allowance, it tries to find the exact word allowance
15:16And instead of home office, if the user asks work from home, it's unable to find that anywhere
15:24These combinations of keywords aren't found in the documents, and thus the document is not found
15:28In our example code, say we say desk instead of furniture, it's not going to be able to find any matches in scores, and thus unable to find any matching document
15:39That's the limitation of keyword search, and that's where we need semantic search
15:44Semantic search searches documents based on the meaning of words, and thus has higher chances of locating the right documents based on the inputs, and that's what we will look at next
15:52So, what exactly is semantic search? Think of it as search that understands meaning, not just words
15:59When you search for allowance, semantic search can find documents about allowance or reimbursements or anything that has similar meaning, even if those exact words aren't used
16:08Similarly, if you search for home office or work from home, it can find documents that have anything to do with remote work
16:14The magic happens through something called embeddings
16:19We convert both your search query and all the documents into mathematical vectors
16:24Think of them as coordinates in a high-dimensional space
16:29Documents with similar meanings end up close together in this space
16:31So, when you search, we find the closest matches based on the meaning, not just word overlap
16:37We can measure how similar two pieces of text are by calculating the distance between their vectors
16:41The closer the vectors, the more similar the meaning
16:45So reimbursement and allowance would have vectors that are close together, even though they're different words
16:50We'll see this in more detail next
16:52Let's now understand embedding models
16:55So if you look at machine learning models, they can be categorized at a high level based on use case, such as computer vision, NLP's, or natural language processing, audio, among many others
17:06And within each category, you have a number of models available
17:09This is as shown on Hugging Face, which is a popular platform where you can discover models, datasets, and applications
17:16Our interest here is the sentence similarity within natural language processing
17:23And within sentence similarity, one of the popular models is Sentence Transformers, all mini LM L6V2
17:31This model maps sentences and paragraphs to a 384-dimensional dense vector space and can be used for clustering and semantic search
17:38It is also a 22 million parameter model
17:41Now, what does that mean? The parameter size reflects the brain power of the model
17:47Think of parameters as the learned knowledge stored in the AI's memory
17:51Each parameter is a number that the model learned during training to understand language patterns
17:5622 million parameters means this model has 22 million learned values that help it
18:04understand how words relate to each other, what sentences mean semantically, which concepts are similar or different
18:11Let's compare that to things we already know, like GPT models
18:12Let's compare this model to GPT 3.5 and GPT 4 models that we use
18:18The 22 million parameter size of our all-mini LLM model is very small compared to the 175 billion parameters of GPT 3.5 and 1.8 trillion parameter size of GPT 4
18:31The size of the model is proportional to that too
18:34The all-mini model is 90 megabytes in size
18:36As such, it can be used locally on our laptops, and the size of GPT 3.5 and 4 are 350 GB and 3.6 TB respectively, and thus the use case differs
18:50The all-mini LLM model is a perfect fit as an embedding model for our use case, whereas the GPT Models are used for text generation and reasoning
18:56So, we just mentioned embeddings
19:03What are they actually? In its simplest form, an embedding model takes text and converts it into numbers that represent meaning
19:09So, a sentence like "dogs are allowed in the office" is converted into an array of numbers known as vectors
19:17When you give the model a sentence like "dogs are allowed in the office," it doesn't just look at the words
19:21Instead, it thinks about what this sentence actually means
19:25Is it about animals? Is it about workplace policies? Is it about permissions? The model then creates a list of numbers that captures all these different aspects of meaning
19:37Each number represents something that the model learned about
19:39language
19:41Maybe the first number captures how animal-related the text is
19:43The second number captures how workspace-related it is, and so on
19:49And it then plots that in a graph
19:55So dogs get a number 0.00005597 and are added to a section of the graph that represents animals and pets also fall into the same category
20:01However, remote does not go there
20:03Similarly, office falls into the workplace area
20:10So, our first sentence moves closer into the workplace section, and so does the second sentence because it is also related to work
20:17And the same applies to the last sentence, as that's also related to the workplace
20:21We then compute the distance between these points
20:24The shorter the distance, the closer they match
20:28So, finally, if You look at these two sentences, you'll see that the first two are similar
20:31That's a similarity search explained in the most simplest of forms
20:35And this explanation only works for a two-dimensional array
20:37But in most cases, the dimensions are too many that we can't even imagine how it would look visually
20:44In this case, the model we are using uses 384 dimensions
20:46So we don't even know how to imagine this or plot that on a graph
20:52So then, how do we calculate similarities between them? This is where the magic of mathematics comes in
20:58Since we can't visualize 384 dimensions, we need a mathematical way to measure how close two points are in this high-dimensional space
21:06The solution is something called the dot product
21:11Think of it as a mathematical ruler that can measure distance in any number of dimensions, even ones we can't see
21:15So here's how it works in simple terms
21:18For the sake of simplicity, I'll convert the vectors for each sentence into two-dimensional vectors of simple numbers
21:26So, "dogs are allowed in the office" gets a vector value of 1, 5
21:28The second sentence gets 2 and 4, and the third one gets 6 and 1
21:34The process involves multiplying the vectors, adding them, and then normalizing them
21:39Let's look at the first two
21:42We first multiply the values in the vectors
21:45So, we multiply 1 * 2 to get 2, and 5 * 4 to get 20
21:52We do the same for the other two pairs
21:57We multiply 1, 5 with 6 and 1 to get 6, 5
22:00And then we multiply 2, 4 with 6 and 1 to get 12, 4
22:03We then add the multiplied numbers together
22:07So 2 + 20 gives us 22, and we get 30 and 16 for the others
22:10And finally, these go through a normalization process to convert these numbers into anything between 0 and 1
22:20That also takes into consideration the total size of the vectors, among other things
22:24Finally, the pair with the value closest to one are similar, and away from one are dissimilar
22:30So that's a basic explanation of how sentences are compared for similarity
22:37Now, of course, you don't have to do all of that math by yourself
22:38We have libraries that do that for you
22:40NumPy is a powerful Python library for working with numbers and mathematical operations
22:47We import NumPy as NP, and then we call the NP dot method and pass in the vectors for it to calculate the dot product between the two vectors
22:56It returns a similarity score between zero and one
23:00So let's take a closer look at that
23:04So first, we install the required libraries, such as the sentence transformers and NumPy library
23:08So the sentence transformers, as we saw, provides the sentence transformer class and the all-mini-LM model
23:14The NumPy provides the NP function for calculating dot products between vectors
23:20So here we can see the complete code in action
23:23We first import the sentence transformers library and the NumPy library
23:28Then we load the all-mini-LM-L6-V2 model that we've been discussing
23:35What it does is it downloads the model, loads the 22 million parameters into memory, prepares a model to convert text into embeddings
23:41We then define our three test sentences about dogs, pets, and remote work, and we then encode these sentences into embeddings using the embedding model
23:51And finally, we calculate the similarity between each pair of sentences using NumPy's dot product function
23:58Now, let's see what happens when we run this code
24:00We print out the similarity scores between each pair of sentences, and the results are quite interesting
24:07Looking at the results, dogs versus pets shows 73.3% similarity
24:12That makes sense because both are talking about animals in the workplace
24:16Dogs versus remote shows only 36.2% similarity
24:19That makes sense, too, because one is about animals, the other is about work arrangements
24:23Pets versus remote shows 33.8% similarity
24:25Again, these are quite different topics
24:28This demonstrates exactly what we've been talking about
24:32The model can understand semantic meaning, not just word matching
24:35Even though dogs and pets are different words, the model recognizes they're both about animals in the workplace context
24:41And it correctly identifies that remote work policies are quite different from animal policies
24:47And this is the foundation of how RAG systems are built
24:49They can find semantically similar content even when the exact words don't match
24:54This is what makes RAG so powerful compared to traditional keyword search
24:58So, so far we've been looking at sentences
25:01Transformers and the all MiniLM L6V2 model
25:04But sentence transformers are just one example of embedding models
25:08There are many other popular embedding models out there that you can choose from depending on your use case
25:12Now, let me clarify an important distinction
25:16The sentence transformers we've been using are local models
25:17They run on your local machine
25:20They're completely free and they don't require an internet connection
25:24But there are also remote or API models like OpenAI's embeddings that run on external servers where you pay to use and need an internet connection
25:32In this sample code, you can see how we use the OpenAI library and use the embeddings API endpoint to create a new embedding
25:37The model is text
25:42embedding 3 small and it returns the embedding vector for it
25:47There's also this leaderboard of top embedding models posted by HuggingFace
25:50We can see some of the most popular ones here, Gemini topping the chart with Quen 3 and others that are following
25:57Well, that's all for now
25:59Head over to the labs and practice working with embedding models
26:01All right, we're now going to look into the second lab
26:04This is called embedding models
26:07So, I'm just going to click on start lab to start the lab
26:08We'll give it a few minutes to load
26:10Okay, so in this lab, we're going to look at uh embedding models
26:15We'll explore semantic search using embedded models, which are the foundation of modern uh RAG systems
26:19So let's uh go to the first task
26:23So the first task is about keyword search limitations
26:27So first, we navigate to the project
26:29We create a new virtual environment and install the requirements
26:33I go to the terminal, and we're going to set up the virtual environment
26:39So our project is within this folder called rag project, and here we have the virtual environment that's being set up
26:44Okay
26:49Okay, we now run the next step
26:54Once the virtual environment is set up, the next step is to run the keyword limitation demo
26:55If you go to the rag project, you'll see the keyword limitation demo script
27:02So, this is a simple script that searches for a word or keyword that does not exist in the documents and proves that pure keyword-based search
27:09Uh, are less likely to yield the right results
27:15For example, in this case, the query is "distributed workforce policies," and none of the documents have something that's exactly like that, right? So, let's try running the script
27:28And if you look at the script, most of the scores are zero because, um, the keywords "distributed workforce policies" does not really exist in any of the scripts
27:35So, the correct answer here is missing synonyms and context
27:44All right
27:45The next task is to install embedding dependencies
27:47So, we go to the RAG project
27:49So, we're already in that project
27:51We source the, uh, virtual environment
27:53We install the embedding packages
27:55So, I'm going to copy, copy this command and install it
27:59So, the packages are Sentence Transformers, Hacking Face Hub, and OpenAI
28:05The next question is to run the local embedding scripts
28:06So, if you see the script name, it's semantic search demo
28:08So let's look at the semantic search demo script
28:12And if you look into this, we can see that the first step is loading the documents
28:14And then we load the local embedding model, which is the all-mini-LM-L6-V2
28:18And then we generate embeddings by calling the method model
28:22And then we pass in the docs
28:25And then we have the query, which is the same query we used before, which is distributed workflows policies
28:28And then we generate embeddings for the query
28:32And then we calculate the similarities using the NP method
28:34And then we print the results
28:37So let's run the Twitter UV run Python semantic search demo
28:48Now, as you can see, in the same set of documents, the script has now identified the relevant documents which have the meaning that's closer to the distributed workforce policies query that we are looking for
28:59So, if you see that for each document, it is given a rating, and that means that it's able to identify the document that has the closest semantic results
29:06We'll go to the next question
29:12So, the task is to look at the results and then say, look at the semantic search results and what is the similarity score between remote work policy and distributed work policies
29:18If you look at the first score, say 0.3982, and that is the score for remote work policy
29:22The next question
29:26This is a multiple-choice question
29:30So, this basically confirms our learning
29:33So, the question is based on the comparison between semantic search and keyword search, which is TF-IDF and BM25 that we saw earlier
29:38Which approach better understands the meaning of queries? Of course, we know that semantic search understands, uh, the meaning of queries better
29:44And that's basically about, uh, this lab
29:45In the next lab, we'll explore, um, vector databases
29:50Let's now understand vector databases
29:52So far, we saw how we could use the sentence transformer libraries and load simple sentences into it to create embeddings and then compare those embeddings to each other in a super simple way
30:02However, we have a bigger task at hand
30:04Our policy co-pilot system, and it has hundreds or thousands of large policy documents
30:09Let's say we have 500 policy documents, each with multiple sections
30:14When a user asks, "What's the reimbursement policy for home office setup?" our system needs to search through all of these documents to find the most relevant ones
30:23Now, if we were to do this the naive way, comparing the query embedding with every single stored embedding, we'd have a big problem because with 500 documents, each with 384 dimensions, that's 192,000 calculations for every single query
30:41This is like searching through a phone book page by page
30:42It works for a small phone book, but imagine trying to find a specific number in a phone book with millions of entries
30:49You'd be there all day
30:52That's where vector databases come in
30:54Think of them as having a smart librarian who knows exactly where to look
30:59Vector databases can retrieve relevant results instantly
31:01They efficiently use resources
31:04They're scalable, and they do that by using smart indexing algorithms
31:08What does indexing mean? Earlier, we saw how we represented documents or sentences on a vector graph and then compared their similarities
31:18But when there are thousands of such policies, it's going to be impossible to compare them
31:23And that's where indexing comes in
31:25Instead of checking every single vector, we pre-organize them into neighborhoods
31:30In this case, the animal policies are grouped together
31:32All health benefits are grouped together
31:37All remote work policies are grouped together
31:39That way, when someone asks about bringing their dog to work, we don't search the entire space
31:43We go directly to the animal policies neighborhood and only search there
31:49Let's look at the three most popular indexing algorithms used by vector databases
31:52HNSW, or hierarchical navigable small world, is the most widely used algorithm
31:58It creates a graph structure where each vector is connected to its most similar neighbors
32:03So, when searching, it starts from a random point and follows the connections to find the closest matches
32:10It's fast and accurate, which is why most vector databases use it by default
32:13IVF, or inverted file
32:16And LSH, or locally sensitive hashing, are other examples of the same
32:20Let's now look at some of the popular vector DB implementations
32:24Chroma is perfect for learning because it's open-source and Python-friendly
32:28We can install it on your computer and start experimenting immediately
32:33It's free, which makes it great for students and small projects
32:37Pinecone is a managed service, meaning they handle all the infrastructure for you
32:41You just send your data and queries, and they take care of everything else
32:45It's used by big companies in production, but you pay per use
32:46There are other great options too
32:49VV8, with its GraphQL API, is another example
32:51But for learning, I recommend starting with Chroma
32:55So the best approach is to start with Chroma for learning and experimentation, and then move up to Pine Cone or similar services for production use cases
33:05So, first, we install the required library, such as the Chroma database
33:07Then, we import the Chroma DBA library
33:10We connect to the client
33:12We create a collection called policies
33:14Chroma creates a new collection in memory, sets up the default embedding model, the all-mini-LM embedding model, prepares storage for vectors and metadata
33:22We then add policy documents to the collection using the collection add command
33:28So, this converts text to the 384-dimensional vector that we spoke about earlier, saves the vector in the collection, and adds the vector to the HNSW index structure
33:38The The document is immediately searchable
33:41To search, we run the collection.query method and pass the query string
33:45Now let's talk about some important Chroma concepts
33:47First, the default behavior of ChromaDB is that it's not persistent
33:52When you create a client with just chromadb.Client(), it stores everything in memory
33:58This means when your program stops, all your data is lost
34:00This is fine for learning and experimentation, but not for production
34:06To make ChromaDB persistent, you need to use a persistent client instead of a client
34:10You specify a path where you want to store the database files
34:13This way, your data survives program restarts, and you can build up your vector database over time
34:18You can also change the embedding model that Chroma DB uses
34:22By default, it uses the all-mini-LM model, but you might want to use a different model for better performance or to match what you used during training
34:30You can use OpenAI's embedding models or even create a custom embedding function using any model you want
34:36In this case, we pass in a new parameter called embedding function that passes in OpenAI's embedding function as a parameter along with the API key
34:45Let's head over to the labs and gain hands-on experience
34:49Okay, let's now look at the uh lab on vector DB
34:52So I'm going to start the lab now
34:56Okay
35:00So the lab has uh what I'm going to do is I'm going, I'm just going to go through a high-level overview of the lab and I'll leave you to do most of It, but I'll just explain how the lab functions
35:04Right
35:07So, uh, in this lab, we're going to learn how to scale the semantic search with vector databases
35:11So let's get that going
35:14So the first task is to simply understand the, uh, concepts
35:16So before we start building, let's, uh, understand what vector databases are
35:21So we already discussed that in the video, but here's a quick, uh, description of what it is and what it can help us do
35:27And there's a question on, um, what is the primary advantage of using a vector database or strong embedding models, um, in memory? So I'll, uh, let you answer that, uh, yourself
35:39The next step is to navigate to the project directory, which is right here
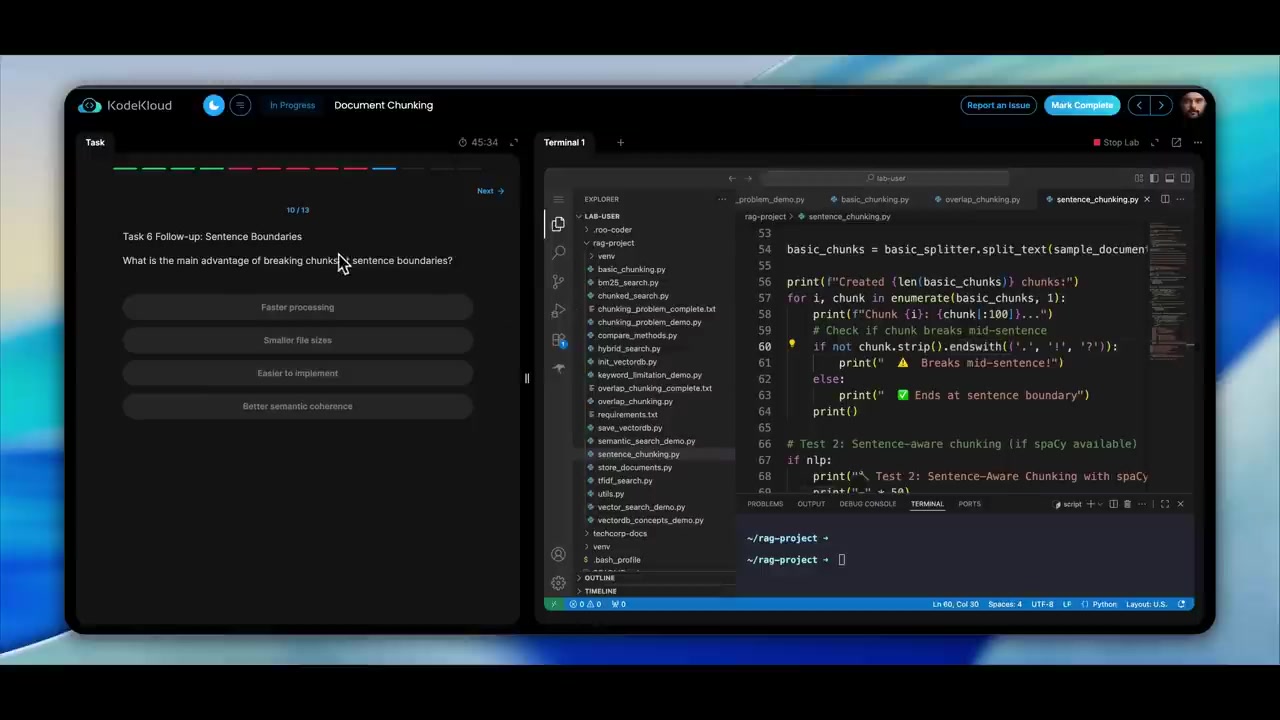
35:43And then, um, we again activate the virtual environment and we install the embedding uh model package, which is sentence transformers, which we also did in the last lab
35:52And then the next step is to install the vector database
35:54In this case, we're going to use Chroma
35:56So, um, the task is to install the Chroma package
36:02Again, I'll just skip through that for now
36:04Uh, the next task is to initialize a Chroma vector database
36:07So, um, if you go here, there's a script called init vector DB, and if you look into the script, we first import the Chroma package
36:15We also have the sentence transformers
36:18Um, we then, uh, create, uh, the Chroma client using the chromadb.client method
36:24And then we create a collection
36:26We'll call it techcorp docs
36:28And then, uh, we load the embedding model, which is all mini LM L6 model
36:34And Then, we um test the model with a sample document
36:41So we have identified a test doc, which is really just a sentence that's given here
36:46Um, we'll then add the test document to the collection using the collection add method, and we'll print the results
36:53And then, uh, we'll print the count of, uh, documents within the collection
36:57And that's basically it
37:02So that's a, a quick, uh, beginner-level, uh, script
37:06In the next one, there are a couple of questions that are being asked
37:07So, uh, you can answer those questions based on the results of the script
37:11The next one is, uh, called as store documents
37:14So this is where we store actual documents within the Chroma DB
37:18Again, this is another script that starts off and loads the model and client
37:23As we did before
37:26But in this case, we're reading the tech corp docs documents using the tech corp docs method, which we have in the utilities function
37:33So that's what loads all the documents that are in the tech corp docs folder
37:39So now we're loading actual documents, and then we follow the same approach of adding those documents to the collection, and then we verify the collection
37:47So again, just another layer to that script, the basic script
37:53In this case, we're just storing documents
37:56We'll continue to the next task
37:58This is where we perform a vector search against the documents
38:01So, um, the script this time is vector search demo
38:06So click on the vector search demo script
38:10And here we have some sample
38:12documents
38:14Um, there are sentences, and then there's a query
38:16Let's now understand chunking
38:17Now that we understood how vector databases work, we have a new challenge
38:22We've been working with simple sentences like, "Dogs are allowed in the office on Fridays." But what happens when we have real policy documents? What if we have a 50-page employee handbook that we want to add to our vector database? Let's think about this practically
38:37We have an employee handbook, 50 pages of policy content, multiple sections per page, complex policies with detailed explanations
38:47What happens when we try to add this entire document to ChromaDB as a single entry? Well, it would work
38:52Technically, ChromaDB would create an embedding for the entire document, but when someone asks what's the remote work policy, they'd get back with the entire 50-page handbook
39:04That's not very helpful
39:07This is what I call the precision problem
39:10Without chunking, when someone asks what's the remote work policy, they get the entire 50-page handbook
39:14The user gets overwhelmed with irrelevant information
39:18They have to search through everything to find what they actually need
39:22But with chunking, we break that handbook into smaller, focused pieces
39:28Now, when someone asks about remote work, they get back just the specific policy sections that are relevant
39:32The user gets exactly what they asked for, clear, focused answers
39:37Now, how do we actually break documents into chunks? There are several strategies, but we'll focus on some of the simplest ones
39:44With fixed-size chunks, we simply take 500 characters per chunk
39:49This is simple and reliable for most use cases
39:52We just split the document into equal-sized pieces, which makes it easy to understand and implement
40:01But there's a problem with this approach
40:03What happens when we split right in the middle of a sentence? We might end up with "dogs are allowed" in one chunk and "on Fridays" in the other
40:12This breaks the meaning and makes it hard for the system to understand the complete information
40:16That's where overlap comes in
40:18We add a 50-character overlap between the chunks, so the end of one chunk overlaps with the beginning of the next
40:24This way
40:29If we do split the sentence, the important context is preserved in both chunks
40:34Now, there are other methods of chunking, like sentence-based chunking, where every sentence is split into a separate chunk, or paragraph-based chunking, where each paragraph becomes a single chunk
40:47Chunking might sound simple, but it's actually quite tricky
40:52The main challenge is finding the right balance
40:54If chunks are too small, we lose context
40:56So, as we saw earlier, if one chunk has "docs are allowed" and the other chunk has "on Fridays," the user would get incomplete information
41:03We'd have poor understanding because we're missing important details, and the information would be fragmented
41:11On the other hand, if chunks are too large, we have poor precision
41:12If we put an entire policy in one chunk, we're back to the same problem we started with
41:19The search would be inefficient because there's too much irrelevant content, and the results would be overwhelming
41:24So, it's important to choose the right strategy based on your requirements
41:28Apart from the fixed-size chunking, there are other methods like sentence-based chunking and paragraph that we saw, but even others like semantic chunking and agentic chunking, that is for now out of the scope of this video
41:40Now, let's build a simple chunking function
41:43This function takes a document and splits it into overlapping chunks
41:47The key features are, it tries to break at sentence boundaries when possible
41:52It maintains the overlap for context and it handles the end of the document properly
41:57Now, this is a simple chunking done by a Python library
41:59Now, let's see how chunking integrates with our vector database
42:03The complete workflow is that we chunk our large policy document, add each chunk to the vector database with a unique ID, and then when we query, we get back the specific chunks that are most relevant
42:17This gives us the best of both worlds
42:19We can handle large documents, but we get precise, relevant answers
42:21Instead of searching through entire documents, we are searching through focused chunks that contain exactly what the user is looking for
42:30Let me share some key principles for effective Chunking
42:32For size guidelines, 200 to 500 characters is a good balance of context and position
42:39With 50 to 100 characters overlap to maintain continuity, you might need to adjust based on your content
42:45Technical documents might need different chunk sizes than general policies
42:49For boundary rules, always try to split at sentences to maintain grammatical integrity
42:53Avoid mid-word breaks to keep words intact and preserve paragraphs to maintain logical structure
42:59Finally, always test the real queries to ensure your chunks actually answer questions
43:04Verify that the overlap reserves meaning and monitor your search results to see if you need to adjust the chunk size
43:10Remember, chunking is all about finding the right balance between context and precision
43:15It's not just about breaking documents into pieces, it's about breaking them in a way that makes sense for your users
43:21All right, let's look into the next lab on document chunking
43:24Okay, in this lab, we're going to look at chunking techniques
43:29So, we'll learn how to optimize RAG performance by breaking documents into focused, searchable chunks
43:38So, first, we activate the virtual environment
43:40So, this is something we have already done many times
43:43All right
43:46Uh, so first, we're going to look at this chunking problem demo script
43:49So, if you expand the RAG project, there should be a script called as chunking problem demo script
43:56The thing is, this script demonstrates the core problem of searching large documents in RAG systems
44:01It creates a sample employee handbook and shows how searching for specific information like, uh, internet speed requirements, returns the entire document instead of just the relevant section
44:12So, uh, we'll see, uh, a large document stored as a single chunk, search queries that should be, that should find specific sections, or results that return the entire document
44:20So here you can see there's a sample document, um, that has multiple sections, and, uh, we're adding that document to the, uh, collection, Chroma, and then we're doing a query for internet speed requirements
44:33So let's run the script and see how it works
44:38So the script runs now
44:42As you can see, it returns the entire document
44:46It's truncated here, but uh, the result shows the, uh, entire document
44:50So that's the problem, uh, with this, uh, approach
44:52So the answer to this is, large documents return irrelevant, uh, results
44:57Next, uh, we will look at some of the, uh, dependencies, libraries, and dependencies that we'll be using
45:05So first, um, we have what is known as LangChain
45:08So if you, uh, don't know what LangChain is, we have other videos that are on our platform
45:13We have a future course that's coming up that will be for LangChain end to end
45:17So do remember to subscribe to our channel to be notified when it comes out
45:21So LangChain is a powerful framework for building RAG applications
45:25It provides recursive character text splitter for smart, uh
45:29document chunking, and there's also the uh spaCy, which is an advanced natural language processing library, and it provides uh it also provides a spaCy text splitter for sentence-aware chunking
45:39So we'll use spaCy for sentence um-aware chunking, and it uh these libraries take care of chunk sizes, overlaps, operators, etc
45:46And we'll install the LangChain and spaCy dependencies
45:51Okay, we'll go to the next question, and we'll first look at basic chunking
45:58So if you open the basic uh chunking script, you'll see that it uses the LangChain uh text splitter um from which we have the recursive character text splitter uh library
46:06So here we have a sample document, and uh this is where we are doing the splitting
46:15So as you can see, we Specify the chunk size, 200, the chunk overlap is 50
46:20So that's the uh 50 characters that's going to be overlap between each chunks or some of these separators that are defined
46:29So we then do a splitter.split text to split the text into different chunks, and then we have, we just go through the chunks and print them
46:35So I'll let you do that yourself
46:41We'll go to the next one, and there's uh a bunch of questions uh that are asked that you can, you have to read the script and understand and answer
46:48So I'll let you do that uh by yourself
46:53The next one we'll look at is sentence chunking
46:54So in sentence chunking, again uh, if you look at the script, we're using spaCy as a library
46:59And then we have um a question that's based on the output of that
47:03script
47:06And then finally, we looked at chunked search
47:09So this is another script that performs a chunked vector search, a demo that kind of connects everything we have learned so far together
47:20So first, we chunk the documents, and then we add these chunk documents to a collection
47:24Uh, and there's a comparison between chunked, no chunking, a collection with no chunking, and a collection with chunking, and then we'll see the difference between the two
47:34Again, I'll let you go through that by yourself, and there's a question that's based on that
47:39So, yep, that's a quick lab on chunking, and I'll see you in the video
47:44Let's now bring it all together to build our RAG system, now that we understand all the individual components of racks, that's retrieval, augmentation, and generation
47:52It's time to see how they all work together in a real system
47:56We've been building our policy copilot system piece by piece, but what does it look like when everything is connected and running in production? So, we know the basic flow: user query goes to retrieval, then augmentation, then generation, and finally response
48:10But this is just the high-level view
48:12In a real system, there are many more components working behind the scenes to make this happen smoothly, efficiently, and reliably
48:18Now, everything we spoke about so far, such as chunking, creating embeddings, storing it in a vector DB, etc., are things that need to be done before the user starts asking
48:25questions
48:33Because loading thousands of documents, chunking and storing them in a DB, and creating embeddings out of them and scoring them, all of that takes a lot of time
48:40And so they go together before this stage, called as a RAG pipeline
48:45Let's take a closer look at that simple RAG pipeline
48:52The RAG pipeline gets the policy documents, chunks them into small pieces using a chunk size of 500 with an overlap of 50 characters, then converts them into embeddings using OpenAI's embedding models, and then finally loads them into a vector DB
49:12Now, when a query comes in, we search the RAG pipeline, and it gives us the necessary chunks of document
49:18We then augment that document along with the user's query and send that to the LLM to generate a response
49:26So that's a super simplistic RAG pipeline
49:28Let's head over to the labs and see this in action
49:32All right
49:36So, this is the last lab in this course, and this one is about building a complete RAG pipeline
49:40So, uh, we'll learn how document chunking integrates with vector search, how query processing connects to retrieval, how context augmentation feeds into response generation, and how the complete RAG pipeline works end-to-end
49:53So, this basically combines everything from the first four labs that we've just done
49:56All right
50:00So, first, we start with setting up the virtual environment
50:03So, the environment is already set up
50:05You just need to activate it
50:08All right
50:12So, first, we start by looking at the Complete RAG demo script
50:15So, we have a single script now that combines everything we've done so far, and uh, we'll start looking at it, uh, section by section
50:27So, there's the first section that has the document loading and chunking, and there's a function for that
50:32We have some sample documents, and then we have a text splitter, and we have all the, uh, chunks that are created here
50:40And then we have section two, which is a vector database setup
50:43Here you can see we set up a Chroma vector database and store the document chunks there
50:46And then we have the, uh, user query processing section
50:52This is where we actually process the user queries, and then we do the actual search
50:56And finally, we have the context augmentation
51:00This is where we build augmented prompts with retrieved context for LLMs
51:06And so here you can see how a prompt is generated with the context in place, which is basically the policies that were retrieved, and then you have the actual question, the user's question itself, and some additional prompt engineering
51:20And then finally, we have the generate response function that generates a response using LLM
51:30And finally, we have the complete RAG pipeline that calls each of those functions, functions that we have written before, and then there's the main function
51:40Well, I'll let you explore this lab by yourself
51:43There's a lot of interesting questions and challenges throughout
51:50This section covers the essential production
51:53concerns
51:56Caching to make systems fast, monitoring to know what's happening, and error handling to keep systems running when things go wrong
52:00Let's start with a fundamental problem
52:03RAG systems are slow
52:06Every query involves multiple expensive operations: generating embeddings, searching vector databases, calling LLM APIs
52:09Without optimization, a single query can take nearly a second
52:14But here's the thing, most queries are repeated or are very similar
52:19People ask the same questions over and over
52:21What's the reimbursement policy for home office setup? Gets asked dozens of times
52:26Caching solves this by storing the results of expensive operations and reusing them
52:31Instead of taking 950 milliseconds, a cache response might then just take just 5 seconds
52:36That's 190 times faster
52:42The key insight is that we don't need to recompute everything for every query
52:47We can cache at multiple levels, the embeddings, the search results, or even the final answers
52:51So there are four main types of caching that we can implement in RAG systems, each solving a different performance bottleneck
52:58Query cache is the simplest
53:00We store complete question-answer pairs
53:02When someone asks, "What's the remote work policy?" again, we return the exact same answer instantly
53:09This works great for frequently asked questions
53:11Embedding cache stores the computed vectors for text
53:13This is useful because generating embeddings is expensive and We often process the same text multiple times, like policy chunks that appear in multiple searches
53:22Vector search cache stores the results of database queries
53:26This helps when similar queries return the same results
53:31Remote work and working from home might return identical chunks
53:33LLM response cache stores the generated answers
53:36This is the most expensive operation to cache, but also the most valuable, since LLM calls are typically the slowest part of the pipeline
53:44The key is to cache at the right level, not too granular, not too broad, and with appropriate expiration times
53:52Let's look at how to actually implement caching
53:54Well, Redis is a popular caching tool because it's fast, supports different data types
53:59and has built-in expiration
54:00The example shows a simple but effective caching strategy
54:05We create a unique cache key by hashing the query and context together
54:07This ensures that different queries can get different cache entries, but similar queries can share the same entry
54:14We check the cache first
54:17If we find a cache response, we return it immediately
54:20If not, we generate the response using our normal RAG pipeline, then store it in the cache with an expiration time
54:27The TTL, or time to live, is crucial
54:30We want to cache long enough to get performance benefits, but not so long that the data becomes stale
54:38For policy documents, a longer TTL might be appropriate
54:40For more dynamic content, we might use shorter TTLs
54:42times
54:44You can't manage what you don't measure
54:46In production, we need to monitor everything to understand how our RAG system is performing and when problems occur
54:53The best metrics are response time, how fast we answer questions, throughput, how many queries we handle per second, error rate, what percentage of requests fail, but RAG systems have their own specific metrics we need to track
55:06Retrieval quality measures how relevant the returned chunks are to the user's question
55:10Embedding performance tracks how long it takes to generate vectors
55:14Chunking efficiency monitors how well we're breaking up documents
55:17We set alerting thresholds to know immediately when something goes wrong
55:23So if response time exceeds 2 seconds, there's a performance issue
55:26If the error rate goes above 5%, then there's a system problem
55:30So the key is to set realistic thresholds based on actual performance, not theoretical targets
55:37So we want alerts that indicate real problems, not false alarms that cause alert fatigue
55:42Now, things will go wrong in production
55:44Vector databases will go down, LLM services will be unavailable, networks will have timeouts, and we need to handle these failures gracefully
55:53The goal is graceful degradation
55:56The system should still work, even if not at full capacity
55:57So users should get some answer rather than an entire error message
56:03So the example shows a cascading fallback strategy
56:08If the full rack pipeline fails, we try keyword search
56:12If that fails, we return the retrieved chunks directly
56:15If even that fails, we use simple text matching
56:20And as a last resort, we return a helpful error message
56:22And we periodically test if the service is back by sending a few requests
56:26And this is, uh, the half-open state
56:29So if those succeed, we close the circuit and resume normal operation
56:32Let's now bring it all together to build our RAG system
56:35Now that we understand the core RAG architecture, we need to talk about what happens when we put these systems into production
56:42Real-world RAG systems face challenges that don't exist in our simple examples: performance issues, failures, and the need to handle thousands of Users
56:50So this diagram shows a complete production RAG system running on Kubernetes
56:55And let me walk you through each layer
56:57So we have a data layer, a RAG pipeline layer, and the application layer, and a monitoring stack
57:04So the data layer includes all our storage systems
57:07So ChromaDB for vectors, Redis for caching, PostgreSQL for metadata
57:12The RAG pipeline layer contains the core RAG functionality broken down into microservices
57:16So query processing, chunking, embedding, generation, retrieval, augmentation, and generation
57:23And each service can scale independently based on demand
57:25The application layer contains all the user-facing services
57:30So there's the web UI, there's the mobile app backend, if There's any the admin interface, etc
57:36These services handle user interactions and present the RAG capabilities through different interfaces
57:41And then we have our complete monitoring stack: Prometheus for metrics, Grafana for dashboards, Jaeger for tracing, and the ELK stack for logging
57:49Now, this layered architecture separates concerns clearly
57:56Applications handle user interactions, the RAG pipeline processes the core functionality, and the data layer provides storage
58:02This can handle thousands of concurrent users while maintaining high availability and performance
58:07Well, that's a high-level overview
58:09We haven't spoken about a lot of advanced topics like multimodal RAG, graph RAG, hybrid search
58:14techniques, federated rack, reranking techniques, query expansion, context compression
58:19To learn more about AI and other uh related technologies, check out our AI learning path on CodeCloud
58:27Well, thank you so much for watching
58:29Do subscribe to our channel for more videos like this
58:31Until next time, goodbye.


 RAG는 LLM이 외부 지식에 접근하여 사용자 질문에 대한 정확하고 맥락에 맞는 답변을 생성하도록 돕는 기술이다.
 RAG 시스템은 문서 청킹, 임베딩, 벡터 데이터베이스를 활용하여 사용자의 질문에 가장 관련성 높은 정보를 검색하고, 이를 LLM에 전달하여 정확하고 맥락에 맞는 답변을 생성한다.