00:00Hello all, my name is Krishna, and welcome to my YouTube channel
00:02So guys, I am super excited to start this new series on one of the most important techniques, which is right now being used in generative AI and agentic AI field, that is nothing but RAG
00:14If you don't know the full form of RAG, it is called retrieval augmented generation
00:18In this specific video, we will try to understand what exactly is RAG, what are the disadvantages of just using the LLM model, and how we are overcoming those disadvantages with the help of RAG, when should we use RAG, and what are the important pipelines that we should take a Note, while developing a RAG application, okay, so all these topics we will be discussing, and as we go ahead, we are going to implement each and every important pipeline with the help of Jupyter notebook, and I will also show you with the help of modular coding, right
00:55So both the ways we will try to implement it
00:58Now, why I'm stressing on this specific series, because nowadays every company is looking for professionals who are, who knows how to build RAG applications, because if you see various AI engineering reports, there, many of the companies, around 60 to 70 percentage of the projects are Specifically on RAG application, so let me quickly go ahead and share my screen and start discussing about RAG
01:23This is just the introduction video of RAG, uh, and as we go ahead, we'll be implementing more amazing examples
01:30So let me quickly go ahead and show you
01:32So this is a simple definition that, uh, I've put up over here, and, uh, in this definition, first of all, we'll try to understand RAG
01:38Okay
01:44So first of all, let's go through the definition, and then I will give you a brief idea what exactly RAG is all about, you know
01:49So here you can clearly see that RAG is the process of optimizing the output of a large
01:56language model, okay
02:03So it references an authoritative knowledge base outside of its training data set source, before generating a response
02:10LLMs are trained on vast volumes of data, as we all know, and use billions of parameters to generally original output for tasks like question answering, translating, and completing sentences
02:22RAG extends the already powerful capabilities of LLM to a specific domain or an organizational internal knowledge base, all without the need to retrain the model, okay
02:33It is a cost-effective approach to improve LLM output, so it's relevant, accurate, and useful in
02:36various contexts
02:40So this is just a basic definition
02:43You can refer to this particular definition
02:44So guys, now let's go ahead and understand about RAG
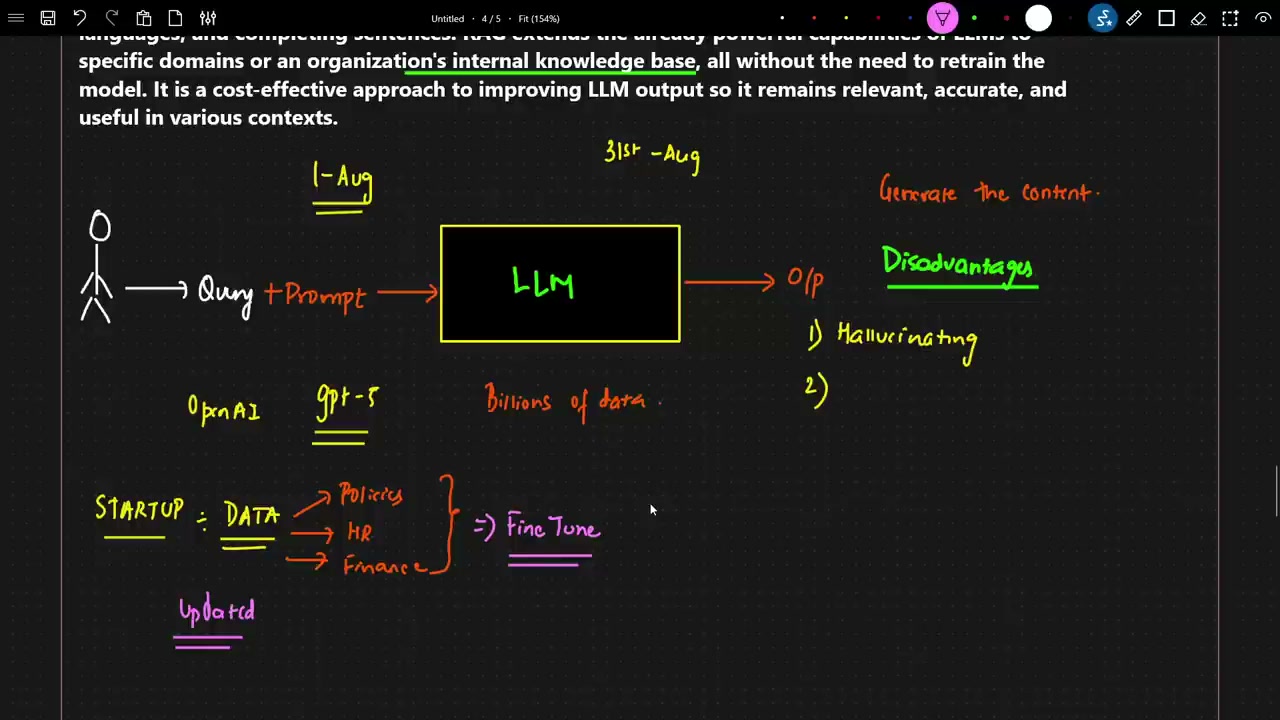
02:48So let's consider that I have a generative AI application, and as you all know, in a generative AI application, usually, let's say that I have an LLM
02:56So this is my LLM
02:59Now, usually whenever we have a LLM, what happens is that, let's consider that I have a user, a user is asking a query
03:07So this is my query from the user, and before it is sent to the LLM, we do add a prompt, right? We do add a prompt, and this prompt is just like an instruction to the LLM, like how the LLM
03:24Should work okay, and then based on this, we actually get an output
03:32Now, this is a simple generative AI application wherein the LLM is used to generate the content
03:41Okay, generate the content
03:50So obviously, by using this specific technique, we give a query, and this LLM, you know, that it has been trained with billions of data, okay, different kind of data that is available in the internet, and based on this, it will be able to generate the output
03:59One of the disadvantage of this, let me talk about the disadvantage of this particular approach
04:06As you know that every LLM that is trained, you know, it will be trained for a specific set of data
04:14So let's say right now it is 31st August, okay, 31st August
04:21Let's say this is my LLM model, and this is basically GPT5, which is the recent model from OpenAI
04:28Now, as you know that when this model was launched, this model may be trained by, may be trained with data till 1st August, okay
04:37So this LLM will not have any idea what has basically happened in the current world between 1st to 31st August, right? And let's say if I go ahead and ask a specific question to the LLM, which is between this specific dates for any kind of events, the LLM will start hallucinating
04:58So one of the major Disadvantages of only using the LLM is that it will hallucinate, okay
05:05When we say hallucinating, what does this basically mean? It means that even though it does not have the knowledge, what has happened between 1st August to 31st August, any events, even though we ask any question, the LLM will try to generate its own answer because it does not want to look like a fool
05:25Okay, that is the best example
05:28It does not want to look like a fool, so it will try to generate some answers and it will make sure that it will, it'll show you answer that you may also have to believe it
05:39That is how it will be written, you know, in in
05:41terms of the output that we get, so usually this condition is basically called as hallucinating, okay? So this is one of the major disadvantages
05:51The second disadvantage that you have, so let's say that I'm using this LLM, and you know, this LLM has been trained with huge amount of data
05:57Now what happens is that I'm running a startup, let's say
06:03Now, in my startup, I'm solving a specific use case, and I have some data which again I need to use this particular data along with my LLM
06:13Okay
06:16So let's say that I have some other data like, you know, um, policies, policies of my company, I have HR policies of my company, I have finance
06:27Policies, you know, and these policies all will not be available in the, it will not be available publicly because it is my startup, so these all data has been protected
06:38Now, I also want to use this specific data and probably create a chatbot, okay? Now how do I do this? Now, one way is that many people will say, "Hey, Kish, we can take this particular data and we can fine-tune the model," right? We can simply fine-tune the model
06:57Yes, this is a very good solution, but understand, fine-tuning a model is a very expensive process, very tedious process, because this LLM, whichever LLM we are using, it has billions of parameter and
07:10Tweaking these billions of parameters usually takes a lot of time, right? So obviously this is a solution, but this is a very expensive solution
07:24Okay
07:39Now, do we have any other way, any other way, and remember these all policies and these all data will also keep on getting updated as we run the startup, right? So every time we cannot just go ahead and fine-tune it, like every day we not fine-tune it, right? So we should try to find out a solution, like how do we prevent this? So this can again be prevented with the help of RAG, right? Now, how it will be prevented with the help of RAG, I will talk about it
07:43Okay
07:48So here
07:53Instead of fine-tuning, I'm saying that, hey, I will go ahead and implement the RAG
07:57Now, you'll understand only when we understand the pipeline of the RAG, which I will discuss in this specific video
08:03Okay
08:09Now, these are the major two disadvantages that you see right over here, and yes, there are some more disadvantages which we'll just deep dive more as we go ahead
08:15Okay, now what happens in, uh, if we use RAG and how we are preventing it? See, RAG is nothing but, it is, it is saying that is a process of optimizing the output of a large language model
08:28So it references an authoritative knowledge base outside of his
08:32Training data
08:37Now, how do we solve this hallucinating and this problem that we have? Okay, so let me just go ahead and draw the diagram again
08:41Okay, so here is my LLM, okay, and here is my query
08:43So let's say that, uh, I am coming up with a user query, so let's consider it over here, okay, and here I'm drawing a user, I'm user, okay, and this user will first of all give a query
08:53Okay
09:02Now, what happens is that there will be two important pipelines that will be created
09:11As I said over here, we are trying to optimize the output of a large language model, so it references an authoritative knowledge base outside of its training data
09:24So, as you all know, this is my LLM, right? This LLM is already trained with a huge amount of data
09:30Now, along with this, I will be having an external database, and this database, we basically say it as a vector database
09:39Okay, external vector database
09:43Now, you know that this LLM is already trained with some amount of data, and any additional data, let's say my startup data, my policies, HR, finance, whatever data is there, we will try to create a data injection pipeline over here, data injection pipeline over here
10:02Now, what will be this data injection pipeline? So, let's say I have my data, from this data we will do Some kind of parsing, and from this parsing, we will do embeddings, embeddings, and then we finally store it into the vector store
10:12Okay
10:21Now, whenever we talk about this specific data, this data can be in any format
10:30It can be in PDF format, it can be in HTML format, it can be in Excel format, it can be even in SQL database format, or unstructured format, any format
10:42So what we do initially, we take this data and we do data parsing
10:48Now here, data parsing is a very important step
10:50I think if you crack this step, then developing a RAG application becomes very easy
10:58Data parsing is all about how do you read the
11:03Unstructured data, or the structured data that is present inside this, and how do you chunk this data, right? How do you chunk, how do you divide this specific data into chunks? Chunking is very important because you need to save this data inside some kind of vector store
11:22This is nothing but vector store or vector DB, okay? Now, vector store and vector DB is nothing but it will actually help you to save vectors inside this, okay? So once you do the chunking, after doing the chunking, you pass it to the embedding models
11:37Now here, in the embedding models, you basically convert text to vectors, okay? Vectors is just Like a numerical representation for text, so that you will be able to apply algorithms like similarity search, cosine similarity techniques that are already available, right, wherein similar kind of results based on a specific query can be retrieved from this particular database
11:50Okay
12:02So here, whenever I talk about vector DB, this is my vector DB or vector store, here we are storing embeddings
12:08Okay
12:13And this embeddings will get applied to every chunk
12:19Embeddings is nothing but we basically use, we convert text into vectors
12:21Here we can use different different embeddings like Google Germany
12:26Embedding models, we can use Open AI embedding models, we can use Hugging Face embedding models, and each and every embedding model exists with different, different costs, and there are also open-source embedding models which will actually help you to convert the text into vectors
12:41Now, this is one specific pipeline which we call it as data injection pipeline
12:45At the end of the data injection pipeline, you are able to store the text into vectors inside your vector DB
12:53Now, how RAG is different from the previous one, right? So initially, you had this data injection pipeline where you are converting all Your data into vectors, right? And this data is specifically for this particular startup, and now I have created a knowledge base
13:11So this is my knowledge base, external knowledge base, or internal knowledge base, whatever knowledge base I have, and this knowledge base does not exist with this LLM, right? Yes, some amount of information may be available, but not the entire part
13:27Now see the definition: it is a process of optimizing the output of a large language so that it references an authoritative knowledge base outside of this training data
13:38Now what will happen when user gives a query? Now this
13:40Query, instead of directly going to the LLM, will go to this vector database, right? And before going here, also, we need to go ahead and apply embedding, right, because this query will be converted into vectors, right? Why do we need to convert into vectors? So that when we are hitting this query to the vector DB, this similarity search is basically applied, and based on this, we get some kind of context, we get some information from the vector DB, and now whatever query I'm asking, okay, if I ask, "Hey, what is the leave policy of my company?", right now what will happen? First of all, it'll go to the vector store, it will gather all the Related information that is available over here, and that information, when it is sending it to the LLM, it is called as context
14:39Now, we use this context along with, we go ahead and write a specific prompt
14:48Now, this prompt is an instruction to the LLM, and it says that you can use this context to answer the question, and finally, you get an output
14:57This is the entire pipeline
15:05This pipeline is basically called as retrieval pipeline, retrieval pipeline, and this is a very good example of a traditional RAG
15:14Now, you may be thinking, Kish, what about other types of RAG? Don't worry, don't worry, I will explain it
15:18Completely from basic to advance with implementation, each and everything, because later on we'll be discussing about agentic RAGs
15:26We'll be discussing how agentic RAGs actually work, each and everything, but I hope you got an idea with respect to this
15:32Now here you will even not be seeing this particular problem, like you'll not completely remove hallucination, but some amount of hallucination, if any queries that is asked related to the data that is present in the vector DB, I will definitely get some kind of context and my LLM will give me the output as, let's say that if that data is not present over here
15:54Then LLM can hallucinate, right? But here we are doing this
15:57See, one best example that you can do is that you can use Perplexity
16:04Perplexity is nothing but it is based on RAG
16:07It is completely developed based on RAG applications
16:09Okay
16:12RAG, it is, it is a kind of a RAG application
16:15In Perplexity, you have connected to various retrievers
16:20You are connected to tools
16:23You are connected to web search, right? And then it is summarizing the output and giving by the LLM, right? And it also uses various LLMs itself
16:31I'm also planning to mostly start a startup soon enough, within a couple of weeks I guess, and the Kind of application that I'm developing is a RAG application only, and it solves a very good problem for a developer
16:40Okay
16:48So that is the reason I'm not being able to upload a lot of videos, because I'm pretty much involved in those startups and working and developing a product that India can definitely remember
16:56Okay
17:04And this is how, you know, this is this is this is how things are, and you can basically see how good, uh, you know, the pipeline actually works, and this is basically a traditional RAG
17:11Now, you may be thinking what all things we'll be discussing
17:14Okay, fine, we have discussed about a traditional rack in the future classes, what coding we'll be doing
17:18Okay, so let's go ahead and talk about it
17:20As I said, two important pipelines we'll go ahead and create, one is a data injection pipeline and one is a retrieval pipeline
17:25Okay
17:30Now in the data injection pipeline, you'll be seeing that we will be performing data injection
17:36Along with the data injection, we will go ahead and do data parsing
17:39Then we'll perform embeddings
17:42Then, uh, we will store everything into the vector store
17:45Then we will create a retriever for this, and whenever a user asks any queries, it will be able to give the context to the LLM and Then finally, we will be generating the output
17:56So here, this is retrieval, this is augmentation, right? This is augmentation over here
18:04Augmentation basically means what? You're giving a context to the LLM along with the prompt to generate the output, right? So this is basically called as augmentation, and finally, you're generating the output, right, which is nothing but generation
18:15So here, you are basically generating
18:20Now, in the next session, how we are going to implement it, first of all, I will show you how to perform these two steps in a very efficient way
18:30Okay, sorry, not these two steps
18:33I will show you how
18:36We can perform these all steps, right? Data injection, data parsing, and embedding
18:40Here, we are going to consider different different files like PDF, HTML
18:43Okay
18:47Um, PDF, HTML, you can consider Excel, you can consider SQL database, you can consider any kind of files
18:50Then we'll do document parsing, and we will try to convert this into document
18:55So, document is an amazing data structure which you can basically use, and you can even parse this, do the chunking, and store it in the vector embeddings, sorry, vector store
19:06Then we'll perform embeddings
19:08Here, we will use both open source, and we are going to use Paid embeddings for the same, okay
19:14And then finally, we go to the vector store
19:16Then, based on a user query, how do we go ahead and apply the same embeddings? We are going to see that, okay, and then finally, we'll be developing this
19:25So mostly, I really want, I'm focusing more on making bigger videos so that you don't just follow a playlist, okay
19:32I want to basically cover a lot of stuff in one video so that you should also be able to efficiently cover it instead of covering 50 different videos
19:41Right now, when we are doing data injection and data parsing, right, there are various techniques, see, we are going to
19:47See, about optimization, we are going to see about various chunking strategies, context engineering, these all kind of topics will be coming up when we talk about data parsing
19:57You know, what is semantic chunker, you know, how do we go ahead and do the chunking in those strategies and all, everything we'll try to discuss as we go ahead, but I hope you got a very super cool idea about what exactly is RAG
20:10Um, yeah, this was it from my side
20:13Uh, please make sure to like the video, share with all your friends, and uh, soon within couple of days, we'll come up with the next video wherein we will be starting the coding tutorial
20:24And we'll start building this data injection pipeline, and I will try to build it in the form of a project, uh, that it'll be looking good for you, so that you'll also be able to completely implement things, right
20:35So yes, this was it from my side
20:37I'll see you in the next video
20:38Thank you
20:38Take care.