

Xây dựng Data Lakehouse tại chỗ với Apache Iceberg | Nessie | MinIO | Lakehouse
Ghi chú insight YouTube này được tạo bằng LilysAI. Đăng ký miễn phí để nhận insight nhanh hơn 10× và sâu hơn từ video.
Q: Các thành phần chính để xây dựng Data Lakehouse tại chỗ là gì?
Các thành phần chính để xây dựng một Data Lakehouse tại chỗ là MinIO (lớp lưu trữ S3), Project Nessie (metastore), và Dremio (công cụ SQL), được thiết lập bằng Docker Compose.
Q: Data Lakehouse là gì và nó cải thiện Data Lake như thế nào?
Data Lakehouse kết hợp các yếu tố của data lake và data warehouse, cung cấp một nền tảng thống nhất để lưu trữ, quản lý và phân tích dữ liệu có cấu trúc và phi cấu trúc. Nó cải thiện data lake bằng cách thêm các tính năng như tiến hóa lược đồ, tính nhất quán giao dịch và khả năng du hành thời gian/khôi phục.
Video này hướng dẫn cách xây dựng một Data Lakehouse tại chỗ bằng cách kết hợp Apache Iceberg, Nessie và MinIO. Bạn sẽ thấy cách Nessie thay thế Hive Metastore để mang lại các tính năng như thay đổi lược đồ, tính nhất quán giao dịch và khả năng quay ngược thời gian cho dữ liệu của bạn.
1. Giới thiệu về Data Lakehouse
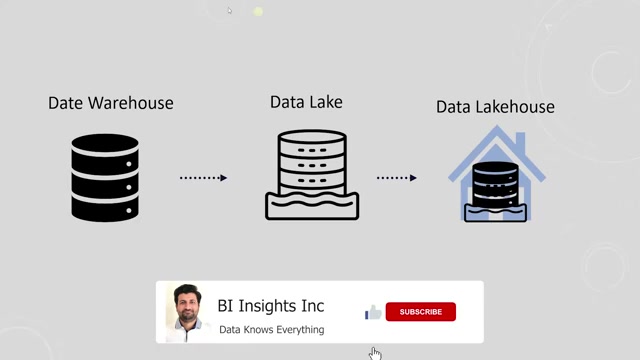 Data Lakehouse là một nền tảng thống nhất để lưu trữ, quản lý và phân tích dữ liệu, kết hợp những ưu điểm của cả data lake và data warehouse.
1.1. Khái niệm Data Lakehouse
- Data Lakehouse là sự kết hợp giữa data lake và data warehouse, mang lại những lợi ích tốt nhất của cả hai.
- Nó cung cấp một nền tảng duy nhất để lưu trữ, quản lý và phân tích cả dữ liệu có cấu trúc và không có cấu trúc.
- Khái niệm này xuất hiện trong bối cảnh dữ liệu lớn và phân tích ngày càng phát triển.
- So với data lake, data lakehouse cải thiện khả năng bằng cách bổ sung các tính năng như:
- Schema evolution (tiến hóa lược đồ): Cho phép thay đổi cấu trúc dữ liệu mà không cần viết lại toàn bộ tập dữ liệu, điều này rất quan trọng khi xử lý các nguồn dữ liệu thay đổi hoặc yêu cầu kinh doanh thay đổi.
- Transaction consistency (tính nhất quán giao dịch): Đảm bảo các thao tác ghi là nguyên tử và hệ thống duy trì trạng thái nhất quán ngay cả khi có lỗi hoặc cập nhật một phần.
- Time travel (du hành thời gian) và rollbacks (quay ngược): Cho phép truy vấn lặp lại bằng cách sử dụng cùng một ảnh chụp nhanh của bảng hoặc cho phép người dùng dễ dàng xem lại các thay đổi và khắc phục sự cố bằng cách khôi phục bảng về trạng thái tốt.
1.2. Xây dựng Data Lakehouse với Apache Iceberg, Nessie và MinIO
- Video này sẽ xây dựng dựa trên khái niệm data lake và giới thiệu các công nghệ mới để biến nó thành data lakehouse.
- Trước đây, một data lake đã được xây dựng bằng MinIO (một lớp lưu trữ tương thích S3) để lưu trữ dữ liệu tạm thời.
- Hive Metastore đã được sử dụng làm catalog để ánh xạ các tệp S3 thành bảng, cho phép sử dụng các công cụ truy vấn để phân tích dữ liệu S3.
- Tuy nhiên, Hive Metastore không hỗ trợ thay đổi lược đồ hoặc đảm bảo tính nhất quán của dữ liệu, đòi hỏi phải bảo trì và cập nhật thủ công các tệp trong S3.
- Trong lần lặp lại này, Hive Metastore sẽ được thay thế bằng Project Nessie và hoạt động với định dạng bảng Apache Iceberg.
- Apache Iceberg là một định dạng bảng quản lý các tệp dữ liệu trong data lake và cung cấp các khả năng quản lý dữ liệu như DML, time travel và rollbacks, tạo thành nền tảng của kiến trúc data lakehouse.
- Nessie lưu trữ tham chiếu đến tệp siêu dữ liệu hiện tại và ghi lại các thay đổi đối với nội dung data lake dưới dạng các commit mà không cần sao chép dữ liệu thực tế.
- Catalog Nessie mang lại sự đảm bảo về tài sản cho bất kỳ giao dịch nào đối với bảng Iceberg, do đó người dùng nhận được một cái nhìn nhất quán về tất cả các công cụ xử lý dữ liệu.
- Để thực hiện demo này, Dremio sẽ được sử dụng để tạo bảng Iceberg và thực hiện các thao tác DML.
- Tất cả các tệp dữ liệu thô sẽ được lưu trữ trong data lake, là một bucket S3 được lưu trữ trên MinIO.
- Docker Compose sẽ được sử dụng để thiết lập data lakehouse với ngăn xếp công nghệ trên.
2. Thiết lập và Cấu hình Data Lakehouse
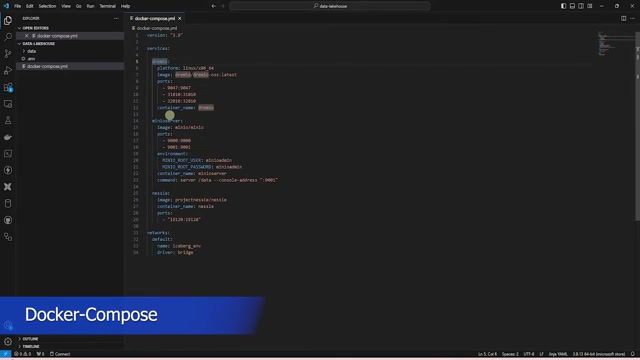 Quá trình thiết lập bao gồm việc sử dụng Docker Compose để khởi chạy các container cho MinIO, Nessie và Dremio, sau đó cấu hình Dremio để kết nối với MinIO và Nessie.
2.1. Khởi chạy và Cấu hình Container
- Docker Desktop là một điều kiện tiên quyết.
- Sử dụng Docker Compose để tạo và khởi chạy các container cho S3 (MinIO), Nessie và Dremio.
- Lần đầu chạy có thể mất thời gian để tải xuống các image từ Docker Hub.
- Cần cấu hình S3 và catalog trong công cụ xử lý dữ liệu Dremio.
- Cấu hình MinIO (S3):
- Đăng nhập vào MinIO và tạo access key và secret key.
- Tạo hai bucket: một cho các tệp dữ liệu (đặt tên là "Data Lake") và một cho schema catalog (đặt tên là "Warehouse").
- Nhập một thư mục chứa tệp CSV vào bucket "Data Lake" để nhập vào bảng Iceberg sau này.
2.2. Cấu hình Dremio
- Khởi chạy và cấu hình Dremio.
- Trong lần khởi chạy đầu tiên, cần tạo người dùng và cung cấp chi tiết cùng mật khẩu.
- Thêm MinIO làm nguồn S3 trong Dremio:
- Trong phần "Sources", chọn S3.
- Cung cấp tên nguồn, access key và secret key đã tạo.
- Bỏ chọn ô "Encrypt connection".
- Trong phần "Advanced option", tìm "Connection properties".
- Đặt CTAS format thành Iceberg.
- Đặt S3 endpoint thành MinIO.
- Đặt S3 access và S3 compatibility thành True.
- Cung cấp tên bucket "Data Lake".
- Lưu các thay đổi.
- Sau khi thành công, bucket "Data Lake" sẽ hiển thị dưới dạng nguồn trong Dremio.
- Thêm Nessie làm nguồn catalog trong Dremio:
- Cung cấp tên cho nguồn catalog và URL của Nessie.
- Loại xác thực là "none".
- Trong phần "Storage", cung cấp access key và secret key, cùng với các thuộc tính kết nối.
- Đường dẫn gốc (root path) sẽ là bucket "Warehouse".
- Lưu nguồn Nessie.
- Nếu thành công, catalog của Nessie sẽ hiển thị dưới dạng nguồn trong Dremio.
3. Làm việc với Dữ liệu và Bảng Iceberg
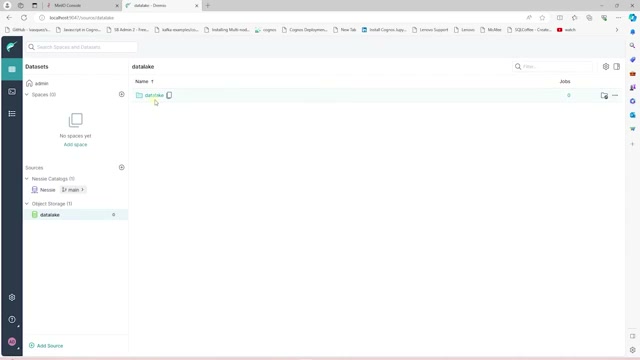
Sau khi cấu hình các nguồn, người dùng có thể xem dữ liệu trong bucket "Data Lake", tạo bảng Iceberg thông qua catalog Nessie, nhập dữ liệu và thực hiện các thao tác DML.
3.1. Khám phá Dữ liệu và Tạo Bảng Iceberg
- Trong Dremio, có thể xem thư mục và tệp dữ liệu trong bucket "Data Lake".
- Chọn tệp dữ liệu và đặt định dạng, dấu phân cách và ký tự thoát.
- Kiểm tra xem dữ liệu có hiển thị chính xác không.
- Nếu tiêu đề cột không chính xác, có thể trích xuất tên cột để sửa lỗi.
- Sau khi lưu thay đổi, người dùng sẽ được chuyển hướng đến công cụ truy vấn.
- Có thể chạy truy vấn trực tiếp trên các tệp dữ liệu.
- Tuy nhiên, việc suy luận lược đồ từ tệp có thể không chính xác.
- Để khắc phục điều này, có thể tạo một bảng Iceberg thông qua catalog Nessie.
- Trong cửa sổ SQL của Dremio, chuyển ngữ cảnh sang catalog Nessie.
- Dán một câu lệnh DDL để tạo bảng có tên là "sales", định nghĩa kiểu dữ liệu cho mỗi cột.
- Thực thi script để tạo bảng.
- Bảng ban đầu sẽ trống và sẽ xuất hiện trong catalog sau vài giây.
3.2. Nhập Dữ liệu và Thực hiện Thao tác DML
- Sử dụng lệnh
COPYđể sao chép dữ liệu từ tệp S3 vào bảng Iceberg đã tạo.- Chỉ định vị trí tệp và tên tệp.
- Sau khi thực thi, lệnh sẽ trả về số lượng bản ghi đã chèn (ví dụ: 60.000 bản ghi).
- Dữ liệu hiện có thể được xem trong bảng.
- Catalog cho phép thực hiện các thao tác DML như update và delete.
- Ví dụ về truy vấn:
- Truy vấn dữ liệu cho một
product_subcategory_namecụ thể (ví dụ: 'caps').
- Truy vấn dữ liệu cho một
- Ví dụ về cập nhật:
- Cập nhật
product_subcategory_namethành 'AWC caps'. - Chạy lại truy vấn trước đó để xác minh rằng giá trị đã được cập nhật.
- Điều này xác nhận khả năng thực hiện các thao tác DML trên dữ liệu bằng catalog này.
- Cập nhật
3.3. Quản lý Lược đồ và Lịch sử Bảng
- Các thay đổi được thực hiện có thể được xem dưới dạng các commit ở bên trái cửa sổ SQL.
- Có thể tải bất kỳ thay đổi nào trong số này và quay lại để kiểm tra.
- Schema Evolution (tiến hóa lược đồ):
- Có thể xóa một cột (ví dụ: cột 'A' trong tập dữ liệu).
- Sau thay đổi này, truy vấn sẽ không còn hiển thị cột đã xóa.
- Có thể cập nhật tên cột bằng câu lệnh
ALTER.
- Có thể tạo các views dựa trên dữ liệu để nhắm mục tiêu các hàng cụ thể (ví dụ: tạo view cho Hoa Kỳ).
- Kiểm tra lịch sử bảng:
- Catalog Nessie theo dõi tất cả các thay đổi và có một con trỏ đến trạng thái hiện tại của bảng.
- Có thể xem lịch sử bảng và các thay đổi ở các giai đoạn khác nhau.
- Với sự trợ giúp của ảnh chụp nhanh (snapshot), có thể quay ngược thời gian để xem bảng trông như thế nào tại một thời điểm cụ thể.
- Ngoài ra, có thể xem các tệp được liên kết với bảng.
- Apache Iceberg mang lại chức năng của cơ sở dữ liệu cho data lake.
- Có thể thực thi các câu lệnh SQL DML trên các tệp data lake.
- Nó mang lại tính nhất quán giao dịch và schema evolution cho thế giới data lake.
- Khuyến khích khám phá thêm về Apache Iceberg.
Hiểu lượng tài liệu khổng lồ như một thiên tài — cùng LilysAI
Hơn 1.000.000 người tìm kiếm tri thức đang dùng Lilys AI.

Chat AI dựa trên nguồn bạn tải lên