00:00안녕하세요
00:00오렌지3로 배우는 데이터 분석 머신러닝 시간입니다
00:22오늘은 지난 시간에 이어서 클래시피케이션을 이미지로 하는 걸 조금 더 해보도록 할게요
00:30import images라는 메뉴를 이용해서 새로운 이미지를 일단 업로드를 해보도록 하겠습니다
00:37오늘 업로드할 이미지는 매우 놀라운 이미지들이에요
00:41깜짝 놀라실걸요? 지금 총 609개의 이미지가 4개의 카테고리로 나뉘어져 있다고 보이시죠? 실제로 이미지 뷰어를 통해서 어떤 이미지인지 보여드리도록 할게요
00:57여러분 이거 보이세요? 지금 보여드리는 이미지는 환자들의 CT 자료라고 보시면 됩니다
01:05CT 결과를 이용해서 의사들은 이게 암인지 암이 아닌지 정상인지를 판단할 수 있잖아요
01:13그런데 오렌지 3는 사실 의사가 아니고요
01:19한 번도 의학 지식을 공부해 본 적이 없습니다
01:22그런데 이런 수많은 데이터를 통해서 오렌지 3를 공부시키면 새로운 CT 사진을 주었을 때 그 CT 사진을 보고 오렌지3가 기존 데이터와의 유사도를 검증해서 암인지 암이 아닌지 진단을 할 수 있게 만들 수 있다는 거죠
01:39여러분 많이 들어보셨죠? 의사들이 진단을 할 때 인공지능을 활용할 수도 있게 되는 시대가 온다
01:47바로 이 오렌지3도 그런 기능을 어느 정도 수행할 수 있습니다
01:51물론 완벽한 정확도를 가지고 있지는 않아서 의사의 마지막 최종 점검이 필요하지만 어떻게 보면 의사들의 진단 시간을 줄여준다는 점에서 인공지능은 꽤 매력적인 도구인 것 같다는 생각도 들어요
02:06이미지는 지난번에도 해보셨지만 이미지를 그냥 임포트만 한다고 해서 이미지에 대한 정보를 컴퓨터가 알아들을 수 없다고 했었어요
02:15그래서 인베딩 기능을 이용해서 이미지를 컴퓨터가 알아들을 수 있는 방식으로 변형해주는 과정이 반드시 필요하다고 했습니다
02:24V3 v3 3 그래서 임베딩된 데이터는 여러가지 모델을 통해서 공부를 시킬 수 있는데 지난 시간이랑 비슷하게 많이 쓰는 모델을 써볼게요
02:49뉴럴 네트워크, SVM, 랜덤 포레스트 이 세가지 모델을 가지고 이 데이터들을 공부시켜 보도록 하겠습니다
03:04이렇게 공부하는데 약간의 시간이 필요한 거 아시죠? 그래서 공부를 시킨 다음에 테스트 스코어를 통해서 얘가 잘 공부를 했는지 확인을 해보려고 해요
03:19테스트 스코어를 연결해 보도록 하겠습니다
03:19우리가 입력한 데이터에도 연결해 주셔야 되고요
03:26각 모델을 통해서 학습한 내용을 연결해 주시면 됩니다
03:33그 다음에 얘가 잘 예측을 했는지를 컴퓨터 매트릭스로 한번 더 확인할 수도 있어요
03:40지금 총 3가지 모델을 통해서 학습을 하고 있기 때문에 시간이 다소 소요되고 이렇게 뱅글뱅글 데이터가 돌아가는 걸 확인할 수 있으실 거에요
03:51잠시 기다려 볼까요? 네, 드디어 모든 분석이 완료되었습니다
03:58테스트 스코어를 클릭해 볼게요
04:02쌤이 지난번에도 말씀드렸다시피 우리는 이 지표들의 값에 주목할 필요가 있는데요
04:08CA, F1, Precision, Recall 이 네 가지 요소는 1에 가까우면 가까울수록 좋은 모델, 그 다음에 로글로스는 수치가 작으면 작을수록 좋은 모델이라고 했어요
04:19그러면 F1 기준으로는 Neural Network가 가장 좋은 모델인 것 같고요
04:19그 다음에 로글로스 기준으로는 SVM이 가장 좋은 모델인 것 같습니다
04:30그럼 이럴 때는 어떻게 해야 되지? 하는 고민이 생기죠
04:33어떤 모델로 예측한 걸 믿는 게 좋을까? 라는 생각이 드실 텐데요
04:38그거에 대한 고민은 조금 있다가 해결해 드리도록 하겠습니다
04:42이제 열심히 공부를 시켰으니까 새로운 데이터셋을 가지고 왔어요
04:47말하자면 지금 막 검사한 새로운 환자가 있었다고 해볼게요
04:5470 우리가 하고 싶은 건 뭐냐면 오렌지3가 열심히 공부한 내용을 바탕으로 새로운 환자의 사진을 예측해 보도록 하는 거죠
05:14그래서 세 가지 모델을 모두 다 연결해 보도록 하겠습니다
05:20그 중에 어떤 게 가장 잘 예측하는지는 모르지만요
05:24일단 확인해 보도록 할게요
05:27그러면 이거 예측을 하는데 시간이 약간 소요되고요
05:31한번 눌러볼게요
05:33지금 총 70개의 데이터가 들어있는데 그 데이터 중에서 각각의 모델별로 1번 파일은 모두 다 정상이다, 암이 아니다
05:442번 파일도 모두 다 정상이다, 암이 아니다
05:46라고 판단했고요
05:483번 데이터부터 대세포 암이다 라고 판단하고 4번 데이터는 평평상피아니다
05:54라고 판단을 했어요
05:54물론 약간 이렇게 6번 데이터처럼 그 암이인지 아닌 암의 종류가 서로 다르게 판정되는 경우가 있기는 하지만 오렌지3의 경우 현재 어느 정도의 수준이냐면요
06:09CT 자료를 보고 암인지 아닌지를 판단하는 건 거의 100% 정확도라고 합니다
06:14대신 어떤 종류의 암인지를 판단하는 데서 약간의 모델별로 차이를 보이고 오류가 있다고 하는데요
06:19엄청난 수준인 거 확인이 되시죠
06:22그래서 이런 식으로 새로운 데이터를 넣었을 때 위약 지식이 전혀 없는 오렌지 3가 어떤 암인지까지 예측을 해볼 수 있다는 게 클래시피케이션의 매력이라고 할 수 있을 것 같아요
06:38멋지죠 여러분? 자 오늘은 조금 전에 보았던 컴퓨전 매트릭스랑 각각의 지표들에 대해서 한번 또 정확하게 알고 넘어가도록 하겠습니다
06:48Confusion Matrix는 말하자면 모델을 통해서 예측된 값이랑 실제 답이랑 어떤 차이가 있는지를 한눈에 보여주는 행렬이라고 보시면 돼요
07:00예를 들어 모델이 예측하기에 negative, 다시 말하면 음성일 거야 라고 예측을 했는데 실제로도 음성인 경우가 true negative입니다
07:12예측도 음성 실제로도 음성 다시 말하면 arm이 아니라고 예측했는데 실제로도 arm이 아닌 경우죠
07:21제일 좋은 형태인 것 같습니다
07:23positive arm first positive 실제로 양성이라고 예측은 했지만 실제로는 아니었던 경우
07:40예측 실패라고 보시면 되겠죠
07:41그 다음에 여기는 어떤 경우냐면 모델이 예측하기를 음성일 거야 라고 예측을 했어요
07:50그런데 슬프게도 실제로는 양성이었던 경우입니다
07:53다시 말하면 제대로 된 진단을 받지 못해서 이 사람은 치료할 기회를 놓치게 되는 제일 안타까운 경우가 되겠죠
08:00모델은 음성이라고 예측했지만 실제로는 양성이었던 false negative입니다
08:07그 다음에 여기는 true positive인데요
08:09모델이 예측하기를 양성이라고 예측했고 실제로도 양성이 그러니까 정말로 환자인 거죠
08:17여기는 치료가 시급한 상태라고 생각하시면 좋을 것 같습니다
08:20이런 식으로 컴퓨전 매트릭스는 여러가지 지표를 구성하는 원리가 되는데요
08:26다음 내용을 한번 살펴보도록 할게요
08:29첫번째 CA, Classification Accuracy 라고 하는데요
08:34우리가 지금 하고 있는 작업이 이런 계속 분류, 군집화 작업이죠
08:38그 중에 Accuracy, 정확도에 대해서 알아보도록 할게요
08:42이 정확도는 어떤 개념이라고 생각하시면 되냐면 전체 예측한 것뿐에 맞춘 것의 개수라고 생각하시면 됩니다
08:49그래서 실제로 컴퓨터 매트릭스 중에서 어떤 부분이라고 보시면 되냐면 전체 이거 TP, TN, FP, FN을 다 더한 여기 전체 사례수 중에서요
08:49맞춘 건 TP랑 TN인 거 아시죠? 양성인데 양성이라고 예측했던 경우 음성인데 음성이라고 예측했던 경우 정확도에 대한 게 분자에 들어가는 값이라고 생각하시면 됩니다
09:15그러니까 이게 높으면 높을수록 숫자가 1에 가까우면 가까울수록 더 유의미한 결과인 거 이해하시죠? 그래서 CA는 1에 가까울수록 더 좋은 수치다 라고 생각하고 계시면 좋을 것 같습니다
09:30두 번째 내용 볼게요
09:30프리시전에 대한 건데요
09:30프리시전은 Positive Predictive Value 라고도 불러요
09:37이렇게 PPV 말하자면 양성인 것을 정확하게 예측한 것에 대한 정도라고 보시면 되는데요
09:44precision은 정밀도라고 보시면 됩니다
09:48이 confusion matrix에서 더 중요한 게 뭐냐면요
09:51양성인데 제대로 예측했는지가 되게 중요한 거잖아요
09:55말하자면 arm인데 arm이라고 예측한 게 굉장히 중요한 요소이기 때문에 그거에 집중한 어떤 평가 지표라고 보시면 됩니다
10:04그래서 모델이 양성이라고 예측한 데이터 수, 다시 말하면 이거죠
10:08이거 중에 예측과 실제가 모두 양성인 TP에 해당하는 거, 이거라고 생각하시면 됩니다
10:15모델이 양성이라고 예측한 것 중에 실제로도 양성인 거, 이걸 정밀도라고 부르고요
10:21이게 높으면 높을수록, 즉 1에 가까우면 가까울수록 당연히 좋을 것 같습니다
10:26그 다음에 세 번째 지표는요
10:26리컬이라고 부르고요
10:26센시티비티 민감도라고도 부릅니다
10:26리컬은 재현율이라고 번역이 되기도 하는데요
10:26이건 어떤 개념이냐면 실제 양성인 모든 데이터수
10:26실제 양성이라면 여기죠
10:26이 표에서 이 밑에 있는
10:45그러니까 양성인데 양성으로 예측이 되기도 하고 양성이지만 네거티브 음성으로 예측을 해서 실제로는 놓친 환자가 있을 수도 있잖아요
10:54이 두 개 중에 실제가 모두 양성인 이 비율을 리컬 재현율이라고 부릅니다
11:01역시 이것도 양성인데 양성으로 예측한 게 좋기 때문에 값이 1에 가까우면 가까울수록 좋은 지표라고 생각하시면 되고요
11:10F1은 뭐냐면요
11:12좀 전에 보았던 프레시전과 리컬의 조합 평균이라고 생각하시면 돼요
11:18F1 1 recall 1 1 그러면 이 F1은 역시나 마찬가지로 precision과 recall의 각각의 장점과 단점을 모두 다 생각한 지표라고 보시면 되고요
11:42그래서 여러가지 지표 중에 한 개만 봐야 된다
11:45그러면 우리는 F1 스코어에 집중하는 편입니다
11:49F1스코어도 1에 가까우면 가까울수록 유의미한 결과다 라고 생각하고 계시면 좋을 것 같아요
11:57마지막으로 로그로스인데요
11:57로그로스는 로그 손실이라고 부르는데 어떤 자료를 예측할 때 우리는 확신에 차서 예측을 하기도 하고요
12:06약간 확실하지는 아닌데 찍는 경우도 있잖아요
12:06말하자면 이 로그로스는 그런 개념이라고 생각하시면 될 것 같아요
12:14두 명의 학생이 수학시험을 봤는데 똑같이 90점을 맞았어요
12:19한 명은 모든 문제를 완벽하게 풀었고 완벽하게 써서 90점을 맞았고 다른 한 명은 몇 문제를 찍어서 맞았다고 할 때 두 학생의 실력을 같다고 보기는 어렵잖아요
12:30그거랑 마찬가지로 얼마나 확신을 가지고 풀었느냐의 문제라고 생각하시면 돼요
12:36 여기에 한번 다시 가볼게요
12:59여러분
13:03좀 전에 해봤던 지표를 잠깐 보시면 F1, 다른 지표가 아니라 한 개만 봐야 된다면 F1을 많이 본다고 했죠
13:10F1 기준으로 가장 좋은 건 뉴럴 네트워크, 그 다음에 로그로스 기준으로는 SVM이 가장 좋죠
13:10다시 말하면 정확도 기준으로 나는 좋은 모델을 뽑겠다 하는 사람은 F1이 좋은 뉴럴 네트워크를 좋은 모델이라고 생각할 거고요
13:28나는 확신을 가지고 뽑은 데이터가 더 중요하다고 생각한다
13:33그러면 로그로스가 낮은 데이터인 SVM 모델을 뽑을 것 같아요
13:39그런데 여러분 이런 모델들을 하나만 꼭 써야 되는 건 아닙니다
13:44그래서 재미있게도요
13:44여기 스태킹이라는 기능이 있거든요
13:47이 스태킹이라는 기능은 뭐냐면 너네 모델들끼리 서로서로의 장점을 합쳐봐 라는 뜻이에요
13:55이거 두 개가 좋은 지표를 가지고 있었죠
13:55그럼 이 두 개의 지표를 합쳐서 새롭게 한번 예측을 해볼래라고 하는 거라고 생각하시면 됩니다
14:06SVM SVM 잠시 기다렸다가 실제로 지표가 더 좋아지는지 한번 확인해 보도록 할게요
14:24이 스태킹은 여러 가지 모델을 협력시키는 거기 때문에 시간이 다소 오래 걸린다는 단점이 있습니다
14:31조금 기다려주세요
14:32네 드디어 끝났습니다
14:32테스트 스코어를 확인해 보도록 할게요
14:42보시면 알겠지만 F1 기준으로는 아직도 뉴럴 네트워크가 가장 좋은 성능을 보이고 있고요
14:51대신 스태킹 기술을 이용해서 SVM과 뉴럴 네트워크를 합쳐놓은 모델이 거의 유사한 수준으로 정확도가 높아진 것을 확인할 수 있습니다
15:05그리고 로그로스는 그 수치가 가장 낮아서 역시 이 두 가지 모델의 장점만을 합친 새로운 모델이 생생한 것 같습니다
15:16그러니까 여러분도 스태킹을 사용하면, 위젯을 사용하면 조금 분석하는 데 시간이 오래 걸리기는 하지만 조금 더 좋은 수치로 예측을 할 수 있기 때문에 스태킹 기술을 사용하는 걸 한번 활용해 보시면 좋을 것 같습니다
15:33여러분 수고하셨어요
15:33오늘도 안녕.


 Orange3를 사용하여 의학 지식이 없어도 방대한 데이터를 학습하여 암 진단이 가능한 분류 모델을 만들 수 있으며, 이는 의사의 진단 시간을 줄여주는 매력적인 도구가 될 수 있다.
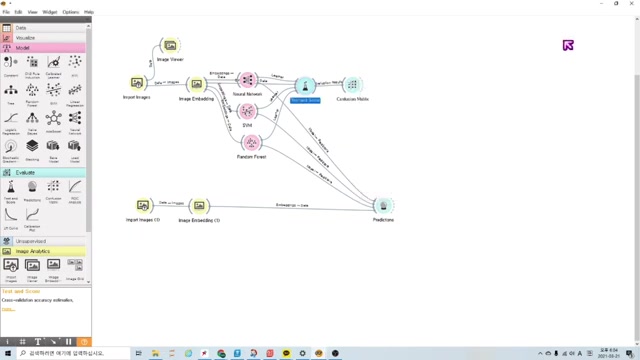 다양한 모델의 예측 결과를 종합하여 더 나은 성능을 얻기 위해 스태킹(Stacking) 기법을 활용한다.