00:00How many calculations do you think your graphics card performs every second while running video games with incredibly realistic graphics? Maybe 100 million? Well, 100 million calculations a second is what's required to run Mario 64 from 1996
00:19We need more power, maybe 100 billion calculations a second? Well, then you would have a computer that could run Minecraft back in 2011
00:30In order to run the most realistic video games, such as Cyberpunk 2077, you need a graphics card that can perform around 36 trillion calculations a second
00:43This is an unimaginably large number, so let's take a second to try to conceptualize it
00:48Imagine doing a long multiplication problem once every second
00:55Now, let's say everyone on the planet does a similar type of calculation but with different numbers to reach the equivalent computational power of this graphics card and its 36 trillion calculations a second, we would need about 4,400 Earths filled with people all working together and completing one calculation each every second
01:17It's rather mind-boggling to think that a device can manage all these calculations
01:25So, in this video, we'll see how graphics cards work in two parts
01:30First, we'll open up this graphics card and explore the different components inside, as well as the physical design and architecture of the GPU, or Graphics Processing Unit
01:41Second, we'll explore the computational architecture and see how GPUs process mountains of data and why they're ideal for running video game graphics, Bitcoin mining, neural networks, and AI
01:56So stick around and let's jump right in
02:07This video is sponsored by Micron, which manufactures the graphics memory inside this graphics card
02:13Before we dive into all the parts of the GPU, let's first understand the differences between GPUs and CPUs
02:23Inside this graphics card, the Graphics Processing Unit, or GPU, has over 10,000 cores
02:30However, when we look at the CPU, or Central Processing Unit, that's mounted to the motherboard, we find an integrated circuit or chip with only 24 cores
02:42So which one is more powerful? 10,000 is a lot more than 24, so you would think the GPU is more powerful
02:52However, it's more complicated than that
02:55A useful analogy is to think of a GPU as a massive cargo ship and a CPU as a jumbo jet airplane
03:01The amount of cargo capacity is the amount of calculations and data that can be processed, and the speed of the ship or airplane is the rate at which how quickly those calculations and data are being processed
03:17Essentially, it's a trade-off between a massive number of calculations that are executed at a slower rate versus a few calculations that can be performed at a much faster rate
03:27Another key difference is that airplanes are a lot more flexible since they can carry passengers, packages, or containers and can take off and land at any one of tens of thousands of airports
03:40Likewise, CPUs are flexible in that they can run a variety of programs and instructions
03:49However, Giant cargo ships carry only containers with bulk contents inside and are limited to traveling between ports
03:58Similarly, GPUs are a lot less flexible than CPUs and can only run simple instructions like basic arithmetic
04:07Additionally, GPUs can't run operating systems or interface with input devices or networks
04:13This analogy isn't perfect, but it helps to answer the question of which is faster, a CPU or a GPU
04:23Essentially, if you want to perform a set of calculations across mountains of data, then a GPU will be faster at completing the task
04:31However, if you have a lot less data that needs to be evaluated quickly, then a CPU will be faster
04:36Furthermore, if you need to run an operating system or support network connections in a wide range
04:45of different applications and hardware, then you'll want a CPU
04:47We're planning a separate video on CPU architecture, so make sure to subscribe so you don't miss it
04:55But let's now dive into this graphics card and see how it works
05:00In the center of this graphics card is the printed circuit board, or PCB, with all the various components mounted on it, and we'll start by exploring the brains, which is the Graphics Processing Unit, or GPU
05:15When we open it up, we find a large chip or die named GA102, built from 28.3 billion transistors
05:23The majority of the area of the chip is taken up by the processing cores, which have a hierarchical organization
05:33Specifically, the chip is divided into seven Graphics Processing Clusters, or GPCs, and within each Processing cluster are 12 streaming multiprocessors or SMs
05:47Next, inside each of these streaming multiprocessors are four warps and one Ray tracing core
05:53And then, inside each warp are 32 CUDA or shading cores and one tensor core
06:01Across the entire GPU are 10,752 CUDA cores, 336 tensor cores, and 84 ray tracing cores
06:12These three types of cores execute all the calculations of the GPU, and each has a different function
06:21CUDA cores can be thought of as simple binary calculators with an addition button, a multiply button, and a few others, and are used the most when running video games
06:32Tensor cores are matrix multiplication and addition calculators and are used for geometric transformations and working with neural networks
06:43and AI and ray tracing cores are the largest but the fewest and are used to execute ray tracing algorithms
06:52Now that we understand the computational resources inside this chip, one rather interesting fact is that the 3080, 3090, 3080 Ti, and 3090 Ti graphics cards all use the same GA102 chip design for their GPU
07:10This might be counterintuitive because they have different prices and were released in different years, but it's true
07:17So why is this? Well, during the manufacturing process, sometimes patterning errors, dust particles, or other manufacturing issues cause damage and create defective areas of the circuit
07:32Instead of throwing out the entire chip because of a small defect, engineers find the defective region and permanently isolate and deactivate the nearby circuitry by having a GPU with a highly repetitive design
07:46A small defect in one core only damages that particular streaming multiprocessor circuit and doesn't affect the other areas of the chip
07:54As a result, these chips are tested and categorized or binned according to the number of defects
08:04The 3090 TI graphics card has flawless GA102 chips with all 10,752 CUDA cores working properly
08:12The 3090 has 10,496 cores working, the 3080 TI has 10,240, and the 3080 has 874 CUDA cores working, which is equivalent to having 16 damaged and deactivated streaming multiprocessors
08:35Additionally, different graphics cards differ by their maximum clock speed and the quantity and generation
08:42of graphics memory that supports the GPU, which we'll explore in a little bit
08:46Because we've been focusing on the physical architecture of this GA102 GPU chip, let's zoom into one of these CUDA cores and see what it looks like inside
08:56This simple calculus is a layout of approximately 410,000 transistors
09:04This section of 50,000 transistors performs the operation of A * B + C, which is called fused multiply and add, or FMA, and is the most common operation performed by graphics cards
09:19Half of the CUDA cores execute FMA using 32-bit floating-point numbers, which is essentially scientific notation, and the other half of the cores use either 32-bit integers or 32-bit floating-point numbers
09:34Other sections of this core accommodate negative numbers and perform other simple functions like bit shifting and bit masking, as well as collecting and queuing the incoming instructions and operands, and then accumulating and outputting the results
09:49As a result, this single core is just a simple calculator with a limited number of functions
09:55This calculator completes one multiply and one add operation each clock cycle, and therefore, with this 3090 graphics card and its 10,496 cores and 1.7 GHz clock, we get 35.6 trillion calculations a second
10:18However, if you're wondering how the GPU handles more complicated operations like division, square root, and trigonometric functions, well, these calculator operations are performed by the special function
10:30units, which are far fewer, as only four of them can be found in each streaming multiprocessor
10:36Now that we have an understanding of what's inside a single core, let's zoom out and take a look at the other sections of the GA102 chip
10:46Around the edge, we find 12 graphics memory controllers, the NVLink controllers, and the PCIe interface
10:51On the bottom is a 6 MB L2 SRAM memory cache, and here's the GigaThread engine, which manages all the graphics processing clusters and streaming multiprocessors inside
11:07Now that we've explored this GA102 GPU's physical architecture, let's zoom out and take a look at the other parts inside the graphics card
11:16On this side are the various ports for the displays to be plugged into
11:21On the other side, is the incoming 12-volt power connector, and then here are the PCIe pins that plug into the motherboard
11:29On the PCB, the majority of the smaller components constitute the voltage regulator module, which takes the incoming 12 volts and converts it to 1.1 volts and supplies hundreds of watts of power to the GPU
11:46Because all this power heats up the GPU, most of the weight of the graphics card is in the form of a heatsink with four heat pipes that carry heat from the GPU and memory chips to the radiator fins, where fans then help to remove the heat
12:02Perhaps some of the most important components, aside from the GPU, are the 24 GB of graphics memory chips, which are technically called GDDR6X SDRAM and were manufactured by Micron, which is the sponsor of this video
12:20Whenever you start up a video game or wait for a loading screen, the time it takes to load is mostly spent moving all the 3D models of a particular scene or environment from the solid-state drive into these graphics memory chips
12:33As mentioned earlier, the GPU has a small amount of data storage in its 6-megabyte shared level two cache, which can hold the equivalent of about this much of the video game's environment
12:45Therefore, in order to render a video game, different chunks of the scene are continuously being transferred between the graphics memory and the GPU
12:55Because the cores are constantly performing tens of trillions of calculations a second, GPUs are data-hungry machines and need to be continuously fed
13:06terabytes upon terabytes of data, and thus these graphics memory chips are designed kind of like multiple cranes loading a cargo ship at the same time
13:17Specifically, these 24 chips transfer a combined 384 bits at a time, which is called the bus width, and the total data that can be transferred, or the bandwidth, is about 1.15 TB a second
13:34In contrast, the sticks of RAM that support the CPU only have a 64-bit bus width and a maximum bandwidth closer to 64 GB a second
13:43One rather interesting thing is that you may think that computers only work using binary ones and zeros
13:51However, in order to increase static transfer rates, GDDR6X and the latest graphics memory, GDDR7, send and receive data across the bus wires using multiple voltage
14:00levels
14:10Beyond just 0 and 1, for example, GDDR7 uses three different encoding schemes to combine binary bits into ternary digits or PAM3 symbols with voltages of 0, 1, and -1
14:19Here's the encoding scheme on how three binary bits are encoded into two ternary digits, and this scheme is combined with an 11-bit to 7 ternary digit encoding scheme, resulting in sending 276 binary bits using only 176 ternary digits
14:38The previous generation GDDR6X, which is the memory in this 3090 graphics card, used a different encoding scheme called PAM4 to send two bits of data using four different voltage levels
14:54However, engineers in the graphics memory industry agreed to switch to PAM3 for future generations of graphics chips
15:02In order to reduce encoder complexity, improve the signal-to-noise ratio, and improve power efficiency, Micron delivers consistent innovation to push the boundaries on how much data can be transferred every second and to design cutting-edge memory chips
15:20Another advancement by Micron is the development of HBM, or the High Bandwidth Memory, that surrounds an AI chip
15:29HBM is built from stacks of DRAM memory chips and uses TSVs, or Through-Silicon Vias, to connect the stack into a single chip, essentially forming a cube of AI memory
15:42For the latest generation of High Bandwidth Memory, which is HBM3E, a single cube can have up to 24 to 36 GB of memory, thus yielding 192 GB of high-speed memory around the AI chip
16:01Next time you buy an AI accelerator system
16:03Make sure it uses Micron's HBM3, which uses 30% less power than the competitive products
16:09However, unless you're building an AI data center, you're likely not in the market to buy one of these systems, which cost between $25 to $40,000 and are on back order for a few years
16:24If you're curious about high bandwidth memory or Micron's next generation of graphics memory, take a look at one of these links in the description
16:33Alternatively, if designing the next generation of memory chips interests you, Micron is always looking for talented scientists and engineers to help innovate on cutting-edge chips, and you can find out more about working for Micron using this link
16:50Now that we've explored many of the physical components inside this graphics card in GPU
16:55Let's next explore the computational architecture and see how applications like video game graphics and Bitcoin mining run what's called embarrassingly parallel operations
17:10Although it may sound like a silly name, embarrassingly parallel is actually a technical classification of computer problems where little or no effort is needed to divide the problem into parallel tasks
17:21And video game rendering and Bitcoin mining easily fall into this category
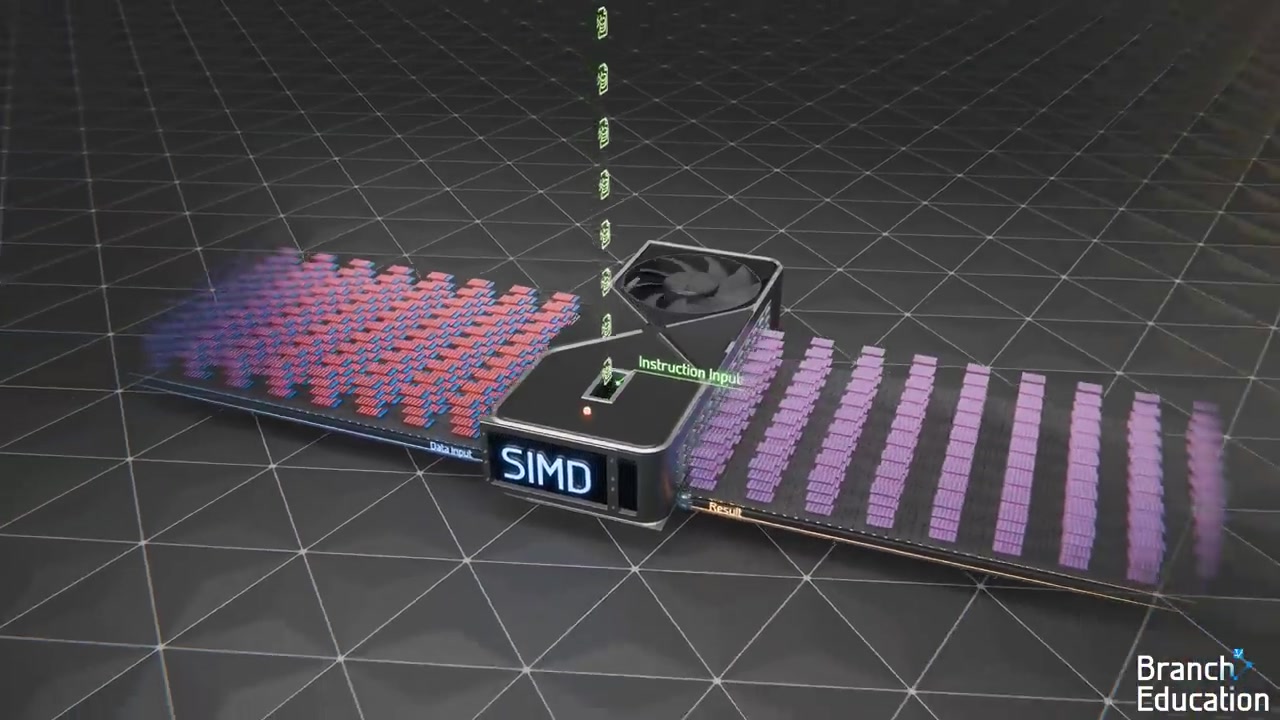
17:28Essentially, GPUs solve embarrassingly parallel problems using a principle called SIMDI, which stands for single instruction, multiple data, where the same instructions or steps are repeated across thousands to millions of different numbers
17:45Let's see an example of how SIMD, or single instruction, multiple data, is used to create this 3D video game environment
17:53As you may know already, this cowboy hat on the table is composed of approximately 28,000 triangles, built by connecting together around 14,000 vertices, each with X, Y, and Z coordinates
18:09These vertex coordinates are built using a coordinate system called model space, with the origin of 000 being at the center of the hat
18:17To build a 3D world, we place hundreds of objects, each with their own model space, into the world environment
18:26And in order for the camera to be able to tell where each object is relative to other objects, we have to convert or transform all the vertices from Each separate model space into the shared world coordinate system or world space
18:41So, as an example, how do we convert the 14,000 vertices of the cowboy hat from model space into world space? Well, we use a single instruction, which adds the position of the origin of the hat in world space to the corresponding X, Y, and Z coordinate of a single vertex in model space
19:05Next, we copy this instruction to multiple data, which is all the remaining X, Y, and Z coordinates of the other thousands of vertices that are used to build the hat
19:16Next, we do the same for the table and the rest of the hundreds of other objects in the scene, each time using the same instructions but with a different object's coordinates in world space and each object's thousands
19:29of vertices in model space
19:31As a result, all the vertices and triangles of all the objects are converted to a common world space coordinate system, and the camera can now determine which objects are in front and which are behind
19:44This example illustrates the power of SIMD, or single instruction multiple data, and how a single instruction is applied to 5,629 different objects with a total of 8.3 million vertices within the scene, resulting in 25 million addition calculations
20:05The key to SIMD and embarrassingly parallel programs is that every one of these millions of calculations has no dependency on any other calculation, and thus all these calculations can be distributed to the thousands of cores of the GPU
20:21Completed in parallel with one another
20:24It's important to note that vertex transformation from model space to world space is just one of the first steps of a rather complicated video game graphics rendering pipeline, and we have a separate video that delves deeper into each of these other steps
20:38Also, we skipped over the transformations for the rotation and scale of each object, but factoring in these values is a similar process that requires additional SIMD calculations
20:51Now that we have a simple understanding of SIMD, let's discuss how this computational architecture matches up with the physical architecture
21:01Essentially, each instruction is completed by a thread, and this thread is matched to a single CUDA core
21:05Threads are bundled into groups of 32 called warps, and the same sequence of instructions is issued to all the threads in a warp
21:15Next, warps are grouped into thread blocks, which are handled by the streaming multiprocessor
21:20And then finally, thread blocks are grouped into grids, which are computed across the overall GPU
21:29All these computations are managed or scheduled by the Giga thread engine, which efficiently maps thread blocks to the available streaming multiprocessors
21:39One important distinction is that within SIMD architecture, all 32 threads in a warp follow the same instructions and are in lockstep with each other, kind of like a phalanx of soldiers moving together
21:51This lockstep execution applies to GPUs up
21:57Until around 2016, however, newer GPUs follow a SIMT architecture, or single instruction multiple threads
22:06The difference between SIMD and SIMT is that while both send the same set of instructions to each thread, with SIMT, the individual threads don't need to be in lockstep with each other and can progress at different rates
22:21In technical jargon, each thread is given its own program counter
22:27Additionally, with SIMT, all the threads within a streaming multiprocessor use a shared 128 kilobyte L1 cache, and thus data that's output by one thread can be subsequently used by a separate thread
22:42This improvement from SIMD to SIMT allows for more flexibility when encountering warp divergence via data-dependent conditional
22:50branching, an easier reconvergence for the threads to reach the barrier synchronization
22:56Essentially, newer architectures of GPUs are more flexible and efficient, especially when encountering branches in code
23:03One additional note is that although you may think that the term "warp" is derived from warp drives, it actually comes from weaving, and specifically the JEA Loom
23:17This loom from 1804 used programmable punch cards to select specific threads out of a set to weave together intricate patterns
23:26As fascinating as looms are, let's move on
23:29The final topics we'll explore are Bitcoin mining, tensor cores, and neural networks, but first, we'd like to ask you to like this video, write a quick comment below, share it with a colleague, friend, or on social media, and subscribe if you haven't already
23:46The dream of Branch Education is to make free and accessible, visually engaging educational videos that dive deeply into a variety of topics on science, engineering, and how technology works, and then to combine multiple videos into an entirely free engineering curriculum for high school and college students
24:08Taking a few seconds to like, subscribe, and comment below helps us a ton
24:16Additionally, we have a Patreon page with AMAs and behind-the-scenes footage, and if you find what we do useful, we would appreciate any support
24:24Thank you
24:32So, now that we've explored how single instruction multiple threads is used in video games, let's briefly discuss why GPUs were initially used for mining Bitcoin
24:40We're not going to get too far into the algorithm behind the blockchain, and we'll save it for a separate episode, but essentially, to create a block on the blockchain, the SHA-256 hashing algorithm is run on a set of data that includes transactions, a timestamp, additional data, and a random number called a nonce
25:01After feeding these values through the SHA-256 hashing algorithm, a random 256-bit value is output
25:06You can kind of think of this algorithm as a lottery ticket generator where you can't pick the lottery number, but based on the input data, the SHA-256 algorithm generates a random lottery ticket number
25:23Therefore, if you change the nonce value and keep the rest of the transaction data the same, you'll generate a new random lottery ticket number
25:29The winner of this Bitcoin mining lottery is the first randomly generated lottery number to have the first 80 bits all zeros, while the rest of the 176 values don't matter
25:42And once a winning Bitcoin lottery ticket is found, the reward is three Bitcoin, and the lottery resets with a new set of transactions and input values
25:52So why were graphics cards used? Well, GPUs ran thousands of iterations of the SHA-256 algorithm with the same transactions, timestamp, other data, but with different nonce values
26:06As a result, a graphics card like this one could generate around 95 million SHA-256 hashes, or 95 million randomly numbered lottery tickets, every second
26:18And hopefully, one of those lottery numbers would have the first 80 digits as all zeros
26:26However, nowadays, computers filled with ASICs, or application-specific integrated circuits, perform 250 trillion hashes a second, or the equivalent of 2,600 graphics cards, thereby making graphics cards look like a spoon when mining Bitcoin next to an excavator
26:44That is an ASIC mining computer
26:49Let's next discuss the design of the tensor cores
26:52It'll take multiple full-length videos to cover generative AI and neural networks, so we'll focus on the exact matrix math that tensor cores solve
27:03Essentially, tensor cores take three matrices, multiply the first two, add in the third, and then output the result
27:11Let's look at one value of the output
27:14This value is equal to the sum of values of the first row of the first matrix multiplied by the values from the first column of the second matrix, and then the corresponding value of the third matrix is added in
27:28Because all the values of the three input matrices are ready at the same time, the tensor cores complete all of the matrix multiplication and addition calculations concurrently
27:38Neural networks and generative AI require trillions to quadrillions of matrix multiplication and addition operations and typically use much larger matrices
27:51Finally, there are ray tracing cores, which we explored in a separate video that's already been released
27:56That's pretty much it for graphics cards
27:58We're thankful to all our Patreon and YouTube membership sponsors for supporting our videos
28:06If you want to financially support our work, you can find the links in the description below
28:10This is Branch Education, and we create 3D animations that dive deeply into the technology that drives our modern world
28:19Watch another Branch video by clicking one of these cards, or click here to subscribe
28:26Thanks for watching to the end.


 그래픽 카드는 GPU(그래픽 처리 장치)를 중심으로 수많은 코어와 고대역폭 메모리를 활용하여 방대한 데이터를 병렬로 처리하며, 이는 비디오 게임 렌더링, AI, 암호화폐 채굴 등 특정 작업에 최적화되어 있다.
 GPU는 SIMD(단일 명령 다중 데이터) 또는 SIMT(단일 명령 다중 스레드) 원리를 사용하여 비디오 게임 렌더링, 비트코인 채굴, 신경망과 같은 병렬 처리에 최적화된 작업을 효율적으로 수행한다.
