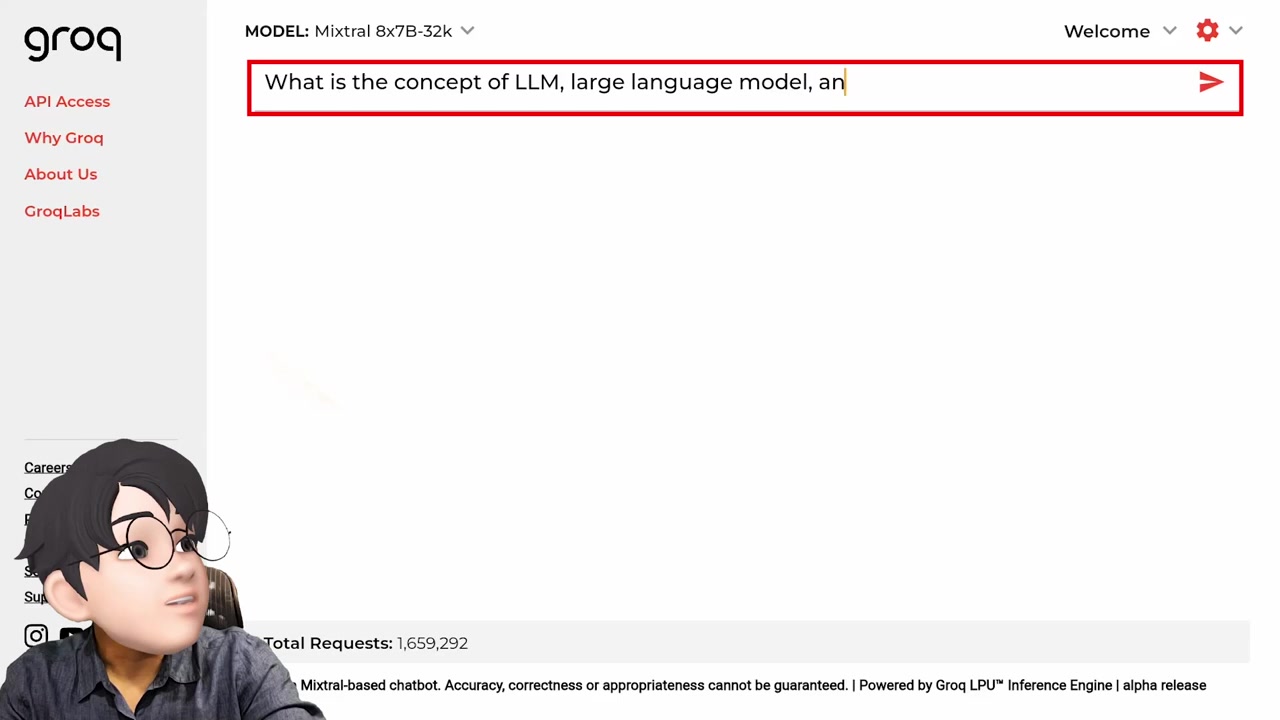
00:00and it 애플리케이션 요렇게 딱 쳤어요
00:03그래서 하나, 둘, 뭐 이렇게 토탈 액티브 리퀘스트
00:04이게 지금 리퀘스트가 더 많아서 그래요
00:06근데 바로 짜자, 나온 거 보이시죠? 그러면서 L&M 타입 오브 아티피셜 인텔리전스 모델입니다
00:09네, 여러분 반갑습니다
00:12안대 공학 에러입니다
00:16챗GPT 다 수십 배 빠른 L&M이 등장해서 지금 화제인데요
00:20일론 머스크의 록이 아닌, GR OQ라고 하는 회사에서 나온 서비스인데요
00:26지금 보시다시피 지금 이미 여기 나오지 않습니까? 초당 토큰 수가 500을 넘어가요
00:30이건 무슨 말이냐? 여기에 뭔가 프롬프트를 치면은, 이렇게 긴 숫자가 그냥 바로 쫙 나와 버린다는 겁니다
00:36Please provide my whole story That was generated based on the options I chose but do not include something something something 하니까 지금 나오십니까? 이게 빨리 감기가 아니에요
00:43그냥 쭉쭉 나온 겁니다
00:51제가 시연에서 보여 드릴 건데, 이게 어떻게까지 이렇게 빠르게 만들어질 수 있느냐? 이게 얼마나 L&M 시장에서 획기적인 사건인지를 지금 설명해 드리도록 하겠습니다
00:58먼저 간단하게만 배경을 짓고 넘어가자면, 지금 보시는 이분, 조나탄 로스
01:02이분이 로크의 CEO이신데요
01:05파운더이시기도 하고요
01:072016년에 설립을 한 다음에, 지금 드디어 요렇게 서비스를 내놓은 게 되겠는데요
01:09이 조나탄 로스라고, 프로세싱 유닛
01:15구글이 설계한 자체 AI 전용으로 추월하는 유닛, 그 칩을 프로젝트를 했던 사람입니다
01:22이 처음에 제시를 했고, 그러고 나서 나와 가지고 이 로크라는 회사를 설립하면서 LPU, 랭귀지 프로세싱 유닛이라는 걸 만들었어요
01:30결국 이 랭귀지 LM에 최적화되어 있는 그런 하드웨어를 전용으로 만들어 가지고 이렇게나 빨리 만들어 낼 수 있었다는 겁니다
01:37그 수치가 얼마나 대단한 숫자야라는 걸 생각해 보시면은, 지금 챗GPT, 그러니까 GPT-4 기준으로 초당 최대 30 토큰이 나온다고 해요
01:46일반적으로는 10 토큰 전후로 나온다고 하니까, 그냥 토큰이라는 것을 하나의 워드라고 하더라도 1초에 10개가 나오면은 뭐 평균 수준이다
01:53보통 70% 정도 나오거든요
01:5610 토큰이 7개의 워드가 나온다라고 봤을 때, 물론 이제 영어 기준으로는 조금 더 워드 수가 이제 많이 나오다 보니까 보통 초당 한 7개 정도 나온다라고 보시면 될 것 같은데, 여기에 나오는 숫자를 봅시다
02:07메타에서 만든 라마 2라는 모델 있죠
02:10이 라마 2라는 모델이 LPU 시스템에서 돌리면 초당 300 토큰까지 갑니다라고 얘기하고 있죠
02:16그러니까 GPT 같은 경우에는 초당 잘해봐야 30인데, 그 수준의 배가 넘는 겁니다
02:20그리고 실제로 이 기록을 세운 거를 보면은 18배까지 빠르다는 얘기가 있거든요
02:24점차 그로크의 이 레코드가 갱신되고 있는 상황이에요
02:28물론 이 메타의 라마 2라는 모델이 GPT 급의 성능을 내지 못하죠
02:33그런데 또 이제 주목을 해야 될 게, 초당 300개의 토큰을 낸다는 것도 중요한데, 우리가 TTF라고 부릅니다
02:39타임 투 퍼스트 토큰
02:41첫 번째 토큰이 나올 때까지의 걸리는 시간, 레이턴시라고 보시면 되는데, 약간 그 제로백 같은 느낌이죠
02:48자동차로 치면은 이게 0.2초에 불가능한 겁니다
02:50그러니까 여러분들이 이렇게 뭔가 뭐 해 줘 뭐 찾아 줘라고 부르는 순간 거의 0.2초 만에 바로 첫 콘티가 나오는데, 그 첫 콘티가 나온 이후로 초당 300개씩 내놓으니까 얼마나 많은 정보가 빠르게 나오는 겁니까? 정말 빠른 거죠
03:02게다가 이 라마 2만이 아닙니다
03:04지금 보시는 거는 여러 가지 LLM 모델에 대해서 나온 것이 되겠는데, 믹스트라고 제가 지난번에 소개해 드린 거 아시죠? 프랑스의 스타트업 미스트랄에서 7 빌리언이십일 AI 모델이 GPT 3.5 수준이 된다라고 얘기를 한 게 있거든요
03:25그 믹스트 버전을 쓰니까 믹스트 8x7B 요걸로 해서 돌려보니까 지금 가로축이 초당 토큰 수인데, 2, 30 수준이에요
03:36말 잘해 봐야
03:39근데 완전 비교도 할 수 없을 정도로 정말 빠르게 나온다는 겁니다
03:41정말 400개 넘는 거니까 초당 단어가 어마무시하게 쏟아지는 거예요
03:45몇백 개가
03:46GPT 3.5, 4 같은 경우에는 아직 이 수준을 못 넘겼고, 라마 2가 그래도 좀 빠르게 나오고 있는데 이것도 Groq가 구현을 한 겁니다
03:54LPU 토대에서 구현을 한 이 칩을 통해서 반도체 칩을 통해서 구현했다는 게 되겠습니다
03:57참고로 믹스트 8x7B 같은 경우에는 파라미터가 한 470억 개 정도 되니까 GPT 3.5의 150억 개보다는 낮은 수준이긴 합니다
04:05근데 이 믹스트 같은 경우에 라마 2나 GPT 3.5의 이 퀄리티, 퀄리티 측면에서 거의 유사하거나 더 나은 성능을 보이는데, 이만큼이나 압도적으로 빠른 속도로 내놓는 거죠
04:16이렇게 되면은 새로운 애플리케이션이 생길 수 있겠죠
04:19그래서 실제로 시연을 해 보도록 하겠습니다
04:20여러분들도 Groq.com에 들어가시면 그냥 지금 바로 쓰실 수가 있어요
04:24여기에 보시면은 선택할 수가 있어요
04:26라마 2랑 아니면은 믹스를 선택할 수도 있을 거고, 향후에 계속 업데이트가 될 것처럼 이렇게 보이시죠
04:31그러니까 LPU라는 전용 하드웨어 엔진이 있는데, 요거를 LLM에 딱 맞게 되니까 정말 빠르게 되는데, 일단 한글로 하니까 좀 느리더라고요
04:36그래서 영어로 물어보면은 "What is the concept of LLM, large language model and its applications?" 요렇게 딱 쳤어요
04:47그래서 하나, 둘, 뭐 이렇게 토탈 액티브 리퀘스트, 이게 지금 리퀘스트가 더 많아서 그래요
04:51근데 바로 짜자잔 나온 거 보이시죠? 그러면서 "LLM stands for Large Language Model, an artificial intelligence model
04:53It is trained on a vast amount of text data..." 그러면서 굉장히 광활하게 어마운트 오브 텍스트 데이터를 학습하고 쭉 나오죠
04:57그러면서 "Some key features" 하면서 "Context awareness" 쭉쭉쭉
05:02이거 천천히 읽어 보시면은 굉장히 잘 나오는 거 보이십니다
05:07이 LLM이 나오는 수준 자체는 미스트랄에서 만든 Mixtral AI 모델의 성능이고, 여기 잘 나오냐 마냐는 Mixtral 자체의 LLM 성능이네요
05:13근데 방금처럼 이렇게나 빨리 나왔다는 거예요
05:17또 쳐 볼까요? "What is the advantage of using NVIDIA GPU H100 in LLM inference?" 뭐 이렇게 쳐볼게요
05:27그러면은 또 이렇게 지금 리퀘스트가 굉장한데, 그럼에도 불구하고 굉장히 빠르게 처리한 거 보시죠
05:31그러면서 "NVIDIA H100 offers high performance, high throughput..." 정말 빠르게 나오지 않습니까? 토큰 수도 실시간 나와요
05:36초당 400개 토큰이다 하면서 하는데, 이게 이 숫자를 볼 필요도 없이 그냥 딱 체감이 되죠
05:40정말 빠르다는 게 느껴지시죠? 이게 어떻게 이렇게 빨라졌고 하면은 Groq에서 지금 보시는 저러한 칩을 만들었죠
05:47자체적으로 칩을 설계를 한 겁니다
05:48이 컴퓨팅을 빠르게 할 수 있는 그로크 같은 경우에는 이 작업 처리 시간이 항상 예측 가능하도록 하드웨어를 설계했어요
05:55이게 무슨 말이냐, LPU라는 게 랭귀지 프로세싱 유닛인데, 이게 결정론적 설계라고 부르는데, 얘네가 응답하는 시간 자체가 항상 일관성을 가질 수 있도록 유지를 한다는 거예요
06:05원래 GPU 같은 경우에는 이제 싱글 인스트럭션 멀티플 데이터(SIMD)라고 부르는데, 이런 SIMD 같은 모델, 일반적으로 CPU, GPU 같은 경우에는 여러 작업들이 막 몰려들면은, 얘네들이 빨리 처리하는 것도 있고 엄청 늦게 걸리는 것도 있고 이러다 보니까 뭔가 얘가 끝날 때까지 얘를 처리 못 하고 이러니까 이 레이턴시가 많이 걸리잖아요
06:23그러니까 어쩔 수 없이 기다리는 시간이 존재를 하는데, 그로크 같은 경우에는 이 모든 작업들이 항상 같은 시간에 정확하게 실행되도록 설계가 되어 있어요
06:30예를 들자면, 약간 기차 탈 때 우리가 기차 탈 때 정해진 시간에 딱딱딱 출발하고 정해진 시간에 도착하도록 되어 있잖아요
06:35그러니까 미리 플래닝을 해 놓은 겁니다
06:36스케줄을 미리 해 놓고, 그래서 미리 여러 스레드를 막 날리는 기존 CPU, GPU 같이 이런 것들을 관리하는 이런 오버헤드를 싹 다 줄이면서 애초에 플래닝을 하면서 시간을 딱딱딱 지켜서 언제 딱 끝나는구나를 알 수 있도록 그 정보를 알고 있으면 뭡니까? 아, 이거 끝나면 그다음 작업 바로 넣어야지
06:51이렇게 설계를 할 수 있겠죠
06:53요런 식으로 하드웨어를 애초에 설계를 했다는 겁니다
06:54그래서 이 로크에서 설계한 거를 이제 텐서 스트리밍 프로세서라고 얘기를 하고 있는데, 하드웨어 구조 자체는 램도 굉장히 많이 들어갔어요
07:02220mbps 가지고 있다
07:04이 어마무시한 양이죠
07:05진짜 엄청나게 많은 양입니다
07:07벡터를 처리할 수 있는 유닛이라는 것도 인트 8, 16, 30 이런 것들 이제 법령 적용이 굉장히 단순하죠
07:13그래서 칩 2 칩 링크가 초당 480gb 이렇게 전송할 수 있고, 여러 가지 인스트럭션을 패하게 처리할 수 있도록 1004개의 큐를 가지고 있다
07:23그러니까 여러 가지로 병렬적으로 처리할 수 있도록 하고 있는 건데, 이 TSP 텐서 스트리밍 프로세서라고 하는 것이 애초에 이 AI 모델이 뭔가 입력이 들어왔으면 이 태스크를 처리해야 되잖아요
07:31L 매어 가지고 처리를 할 때에 복잡한 거를 빠르게 처리할 수 있도록 얘네들의 데이터가 어떻게 처리되고 있는지를 각각 이정표를 알고 있다라는 거예요
07:37그래서 이렇게 스태틱 한 스케줄링, 그러니까 정적으로 이게 스케줄링을 함으로써 이 전체 시스템이 어떤 작업을 실행하기 전에 모든 계산 작업들을 미리 계획을 하고, 거기에 대해서 다음 작업들을 딱딱딱 테스트를 할 수 있도록 구동을 하는 아키텍처를 가진다는 겁니다
07:51거기다가 이 또 디터니 틱한 네트워킹을 가지고 있다고 얘기를 하고 있는 것이, 이게 어떤 신호들이 이제 왔다 갔다 할 거잖아요
07:56그냥 단순하게 어디에서 어디로 가는 게 아니라 막 복잡하게 왔다 갔다 할 거예요
08:00네트워킹을 구성을 하고 있는 건데, 이 데이터들의 모든 트래픽이 그로크 컴파일러에서 사전 계획이 된다
08:03요것도 비슷한 말이죠
08:05어떠한 신호가 여기에서 절로 가야 됩니다
08:07메모리 유닛에서 백투 유닛으로 가야 됩니다
08:10어떤 특정한 작업들을 처리를 할 때에 이런 것들을 미리 정해 놓고 하고 있으니까 그냥 오는 대로 처리하는 CPU, GPU
08:16방식이 아니라 딱딱 맞아떨어질 수 있도록 하니까, 기존에 있는 AI 모델들을 더 빠르게 구동시킬 수 있는 요런 것들을 가지고 있다라는 거죠
08:22아, 역시 구글의 TPU 만든 그런 엔지니어의 발상이 아닌가 싶고요
08:26그리고 소프트웨어랑 이렇게 동기를 잘 맞춰 가지고, 중간에서 소프트웨어가 이걸 다 조율을 해 가지고 더 확실하게 언제 끝나냐, 잘 말지 할 수 있도록 처리를 한다고 하네요
08:35이런 칩들이 막 이렇게 쌓여 가지고 여러 가지의 이제 파드에 들어가 가지고 렉에 쌓여서 엄청나게 많은 슈퍼컴퓨터가 되는 건데, 이게 정확도도 굉장히 좋은 게, 애초에 여기 보시는 것과 같이 INT 8 구조와 16 구조를 다 가지고 있거든요
08:47얘를 빠르게 하기 위해서 보통은 이제 INT, 뭘 얘기하면 정수형을 표현하는데, 여덟 비트를 쓰겠다는 거예요
08:53예를 들어 양수 정수만 사용한다면 0부터 255, 2의 8승이죠
08:570부터 255까지의 숫자로만 표현하겠다
09:01플로팅 포인트 16이라는 16비트를 사용한다는 거거든요
09:03그러니까 32,767개
09:06그렇게 표현할 수 있는 많은 것들을 플로팅 포인트로 표현한다는 건데, 요거를 그대로 쓴다라는 겁니다
09:09그러니까 이 속도를 빠르게 하기 위해서 INT 형이나 플로팅 포인트 이런 거를 8이나 4로 낮추지 않고, 이걸 그대로 지원을 하면서 1.5 패터 플러스를 지원을 하도록 요렇게 처리를 하는데, 서로 네트워킹을 이렇게 빠르게 할 수 있도록 하는 거고, 거기에 대한 스케줄링을 미리 플래닝에 처리한다는 거죠
09:24거기다가 LPU 같은 경우에는 이게 오픈소스 모델로 가와서 캐패시터를 계속 늘리고 있어요
09:28그래서 이 칩을 카드에 넣어 가지고, 그렇고 노드에 한 다음에 이렇게 렉을 구성해 가지고 빠르게 처리할 수 있도록 지원을 하는데, 각각의 칩도 빠르지만 이렇게 렉을 구성해서 네트워킹이 잘되다 보니까 훨씬 더 빠르게 처리할 수 있는 부분이 있는 것 같습니다
09:39자, 여러분, 이게 정말 빠름으로 인해서 갑자기 또 생태계가 바뀔 수가 있어요
09:44어떤 말씀 드리고 싶으냐, LLM 자체가 우리의 언어를 발생시킬 수 있다라는 것만으로도 굉장히 놀라웠는데, 그냥 이 속도 자체가 너무너무 빠른 거예요
09:50우리가 정말 느리기 때문에 할 수 없는 것들이 굉장히 많거든요
09:53근데 이게 정말 빠르고 클릭 한 번에 바로 된다라고 하면은, 일단 가장 생각할 수 있는 게 예를 들어 실시간 번역 같은 것도 금방 바로 처리가 될 수 있겠죠
10:01그래서 국제 회의에서 비디오 콜이라고 컨퍼런스 콜 하는데 즉각적으로 언어를 바꿀 수 있는 요런 것에서도 활용할 수가 있을 거고, 우리가 뭐 주식을 할 때도 금융 보고서를 빨리빨리 처리를 하고 해석을 할 수 있는 이런 것들에도 바로바로 쓸 수가 있을 겁니다
10:12그러니까 실시간 자체가 중요한 거 있잖아요
10:14그리고 뭐 게임에서도 즉각적으로 반응해야 되고 총 쏘야 되고 이럴 때도 바로 될 거고, 코딩을 할 때나 디버깅 할 때도 이런 것은 빠르면 빠를수록 좋기 때문에 생산성이 어마무시하게 늘어날 수가 있겠죠
10:23거기다가 실제로 우리가 원격 의료 진단이라든가 아니면 원격이 아니다 하더라도 의료적인 측면에서 이렇게 빠르게 의 판단을 내려서 수술을 한다거나 이런 부분에서도 바로 적용할 수 있기 때문에, 그동안은 실시간으로 적용할 수 없었던 모든 애플리케이션에 LLM 정확도가 높아지게 되면은 이게 가능하다는 겁니다
10:37로커 같은 경우에는 하드웨어를 만들면서 이렇게 LPU 접근을 하고 있기 때문에 다양한 AI 모델들이 이 칩에 들어오게 되면서 빠르게 처리할 수 있는데, 홍보가 될 수 있는 거고
10:45최근에는 이게 이 로크의 첫 번째 LPU 버전이 삼성 파운드리 4나노 공정으로 만들어진다, 뭐 이런 뉴스가 있어서 떴었죠
10:51근데 이게 공정에 점점 올라가면 갈수록 하드 속도도 점차 빨라질 거고, 계속 증대되면서 LLM 시장을 또 완전 바꿀 수 있는 그런 게 오지 않을까 싶습니다
10:59사실 일주일 전에 제가 로크를 사용하긴 했는데, 정말 놀라서 이거를 빨리 만들어야겠다 하면서도, 그다음에 재미나 1.5 프로도 나오고, 소라도 나오고, 요즘 AI 풍년입니다
11:08그래서 제가 정말 너무 정신이 없는데, 그럼에도 불구하고 이렇게 빠르게 AI 발전이 되면서 생태가 바뀌어 가는 것을 보니, 콘텐츠 풍년인 세상에서 더욱 더 기뻐하고 있는 안대 공화.