
Groq spiegato: è davvero il chip AI più veloce al mondo?
Questa nota di insight su YouTube è stata creata con LilysAI. Iscriviti gratis e ottieni insight 10× più rapidi e approfonditi dai video.
Q: È il chip AI più veloce al mondo?
Groq raggiunge 430 token al secondo, 4-5 volte più veloce della media degli altri servizi di inferenza e fino a 18 volte più veloce per Llama 2.
Il chip IA Groq è il più veloce al mondo? La sua memoria on-chip riduce la latenza e i costi, superando le GPU Nvidia in velocità di risposta, ma la scalabilità per modelli più grandi rimane una sfida.
1. Il Chip IA Groq: Velocità e Innovazione
 Il chip IA Groq si distingue per la sua velocità eccezionale e un'architettura innovativa basata sulla memoria on-chip, che mira a rivoluzionare l'elaborazione del linguaggio naturale.
1.1. Origini e Caratteristiche del Chip Groq
- Groq è un chip IA progettato e prodotto interamente negli Stati Uniti, a differenza di molti concorrenti che dipendono da tecnologie di produzione e packaging asiatiche.
- Il chip è un ASIC (Application-Specific Integrated Circuit), specificamente creato per l'elaborazione del linguaggio.
- Attualmente, il chip è fabbricato da Global Foundries utilizzando un processo a 14 nanometri, una tecnologia matura che ne riduce i costi e aumenta la robustezza.
- Una nuova generazione di chip Groq è già in sviluppo, che sarà prodotta da Samsung con un processo a 4 nanometri in Texas.
1.2. Prestazioni e Benchmark del Chip Groq
- Il chip Groq offre una velocità di inferenza IA eccezionale, riducendo drasticamente i tempi di risposta rispetto ai sistemi tradizionali.
- A differenza delle conversazioni con ChatGPT che possono richiedere 3-5 secondi per una risposta (a causa delle GPU Nvidia nel cloud Microsoft Azure), il sistema Groq, utilizzando un modello open-source come Mixtral, fornisce risposte in meno di un quarto di secondo.
- I benchmark ufficiali mostrano che Groq offre un throughput significativamente più elevato a un costo comparabile o leggermente superiore rispetto ad altri servizi di inferenza IA.
- Per 1 milione di token, Perplexity (su GPU Nvidia nel cloud Amazon) costa circa 25 centesimi e offre 150 token al secondo.
- Groq costa circa 30 centesimi per 1 milione di token, ma raggiunge circa 430 token al secondo.
- In media, il sistema Groq è 4-5 volte più veloce rispetto ad altri servizi di inferenza IA.
- Per modelli come Llama 2 di Meta (70 miliardi di parametri), Groq è fino a 18 volte più veloce rispetto ai provider cloud basati su GPU.
1.3. Architettura Innovativa: La Memoria On-Chip
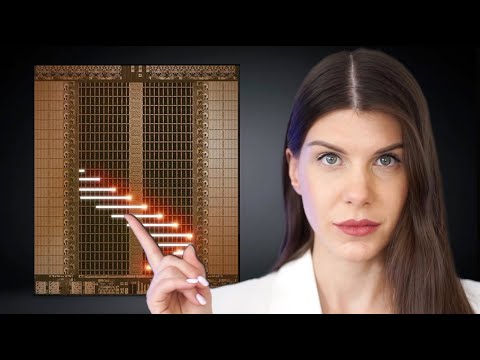
- Il design del chip Groq è caratterizzato da migliaia di blocchi ripetuti, simili a celle solari, che ospitano la sua memoria interamente on-chip.
- Questa architettura differisce dalle GPU Nvidia, che utilizzano una grande quantità di memoria off-chip.
- La memoria on-chip offre due vantaggi principali:
- Minimizzazione della latenza: La vicinanza tra l'unità di calcolo (matrix unit) e la memoria riduce drasticamente la latenza, spiegando le risposte incredibilmente rapide osservate.
- Groq raggiunge 430 token al secondo con una latenza di soli 0.3 secondi.
- Riduzione dei costi e della dipendenza tecnologica: Il chip non richiede costose tecnologie di packaging avanzato o chip di memoria da produttori esterni (come i giganti coreani o TSMC), rendendo la sua fabbricazione più economica.
- Minimizzazione della latenza: La vicinanza tra l'unità di calcolo (matrix unit) e la memoria riduce drasticamente la latenza, spiegando le risposte incredibilmente rapide osservate.
- L'uso di processi di fabbricazione più maturi (come i 14nm) e l'assenza di packaging sofisticato contribuiscono a costi inferiori per wafer e chip.
- Questa flessibilità permette a Groq di passare facilmente tra diverse fabbriche, come dimostrato dalla migrazione da Global Foundries a Samsung per processi più avanzati.
1.4. Funzionamento Interno del Chip Groq
- Il chip Groq è composto da un'unità di calcolo principale (matrix unit), presente sia sul lato sinistro che destro del chip.
- Ogni millimetro quadrato del chip è in grado di eseguire un tera-operazione al secondo.
- L'unità di calcolo è seguita da unità di memoria e unità vettoriali che trasmettono i risultati tra loro, permettendo lo streaming dei dati in entrambe le direzioni (est-ovest e ovest-est).
- Le prestazioni complessive sono il risultato della co-progettazione tra hardware e software, creando uno stack completo e ottimizzato.
2. Modello di Business, Mercato e Sfide di Groq
 Groq si concentra sull'inferenza come servizio, mirando a un mercato in crescita di aziende che necessitano di elaborare modelli IA, ma affronta sfide significative legate alla scalabilità per modelli di grandi dimensioni.
2.1. Modello di Business e Mercato di Riferimento
- Il modello di business di Groq è principalmente focalizzato sull'inferenza come servizio (inference as a service), piuttosto che sulla vendita diretta dei chip.
- L'inferenza è vista come un problema costante e un mercato più ampio rispetto all'addestramento dei modelli IA, che è un'attività una tantum.
- Questo mercato è in costante crescita con l'aumento dell'uso dell'IA generativa da parte di utenti e aziende.
- Groq accelera modelli IA open-source (come quelli di Mistral e Meta) sul proprio hardware per aziende che desiderano utilizzarli nelle loro applicazioni.
- Groq si rivolge a medie e piccole imprese che necessitano di eseguire i propri modelli IA, un segmento di mercato vasto e in espansione, distinto dai grandi provider cloud come Amazon, Microsoft Azure e Google Cloud.
- Attualmente, i servizi di inferenza di Groq non sono ancora redditizi, ma l'azienda punta a raggiungere il pareggio entro la fine del 2024 aumentando la capacità di elaborazione per chip e il numero totale di chip.
- Il successo dipenderà dalla capacità di Groq di scalare rapidamente per tenere il passo con lo sviluppo dell'IA.
2.2. Impatto dell'IA Veloce e Sfide di Scalabilità
- La velocità e la bassa latenza del chip Groq potrebbero essere rivoluzionarie per molte applicazioni, migliorando l'interazione con chatbot e assistenti vocali, rendendola più naturale.
- Tuttavia, l'architettura del chip Groq presenta sfide significative per la scalabilità con modelli IA molto grandi.
- Un modello come Mistral (50 miliardi di parametri) richiede circa 578 chip Groq, mentre lo stesso modello può funzionare su solo due GPU Nvidia H100.
- Per modelli con trilioni di parametri, la memoria on-chip limitata (220 MB per chip) di Groq diventa un collo di bottiglia.
- Un modello da 10 trilioni di parametri richiederebbe decine di terabyte di memoria, necessitando di decine o centinaia di migliaia di chip Groq interconnessi.
- La distribuzione del carico e il networking di un numero così elevato di chip mantenendo una bassa latenza rappresentano una sfida considerevole, la cui fattibilità è incerta.
3. Competizione e Prospettive Future di Groq
3.1. Confronto con i Concorrenti
- L'architettura di Groq è diversa da quella di acceleratori IA come quelli di Nvidia, Google e Tesla, ma presenta somiglianze con il wafer-scale engine di Cerebras, che anch'esso utilizza memoria on-chip distribuita attorno ai core.
- Il chip Groq è di grandi dimensioni (46.225 mm²), mentre un singolo wafer da 300 mm potrebbe ospitare circa 65 chip Groq.
- Cerebras sembra avere un'architettura più scalabile e si concentra sulla vendita di hardware per la costruzione di infrastrutture per altre aziende.
- Rispetto alle GPU Nvidia, Groq supera le prestazioni delle H100 in termini di latenza e costo per milione di token, ma non ancora in throughput.
- Nvidia sta per lanciare la nuova GPU B100, prodotta con un processo a 3 nanometri, che si prevede raddoppi le prestazioni delle H100.
3.2. Outlook e Sviluppi Futuri
- Groq è considerata una startup promettente, insieme a Cerebras, ma il suo successo dipenderà dallo sviluppo del suo stack software e dalla prossima generazione di chip a 4 nanometri.
- Le prestazioni attuali sono state ottenute con il chip a 40nm, e il sistema completo ha richiesto tempo per essere sviluppato.
- La prossima generazione di chip promette miglioramenti significativi in termini di velocità ed efficienza energetica.
- Si osserva una tendenza verso chip specializzati: dai CPU e GPU si è passati a NPU (Neural Processing Unit) e ora Groq definisce i propri chip come LPU (Language Processing Unit), specificamente ottimizzati per l'elaborazione del linguaggio naturale e gli ASIC.
- L'evoluzione verso chip specializzati rappresenta una tendenza chiave del secolo.
Comprendi enormi quantità di materiale come un genio — con LilysAI
Oltre 1.000.000 di cercatori di conoscenza usano Lilys AI.

Chat IA basata sulle fonti caricate